LMEB亮相NVIDIA GTC Berlin 2026,业界首个大规模智能体长程记忆嵌入基准
导读
2026年10月21日,黄仁勋在NVIDIA GTC Berlin 2026(GPU Technology Conference)官方主题演讲中介绍“NVIDIA Agent Knowledge Foundation(智能体知识基础)”时,展示了长程记忆嵌入基准LMEB的模型榜单,并将其作为Nemotron系列嵌入模型的性能评测依据之一。联合团队研发的KaLM-Embedding同样出现在榜单中,评测基准与模型成果因此共同进入NVIDIA的公开技术展示。
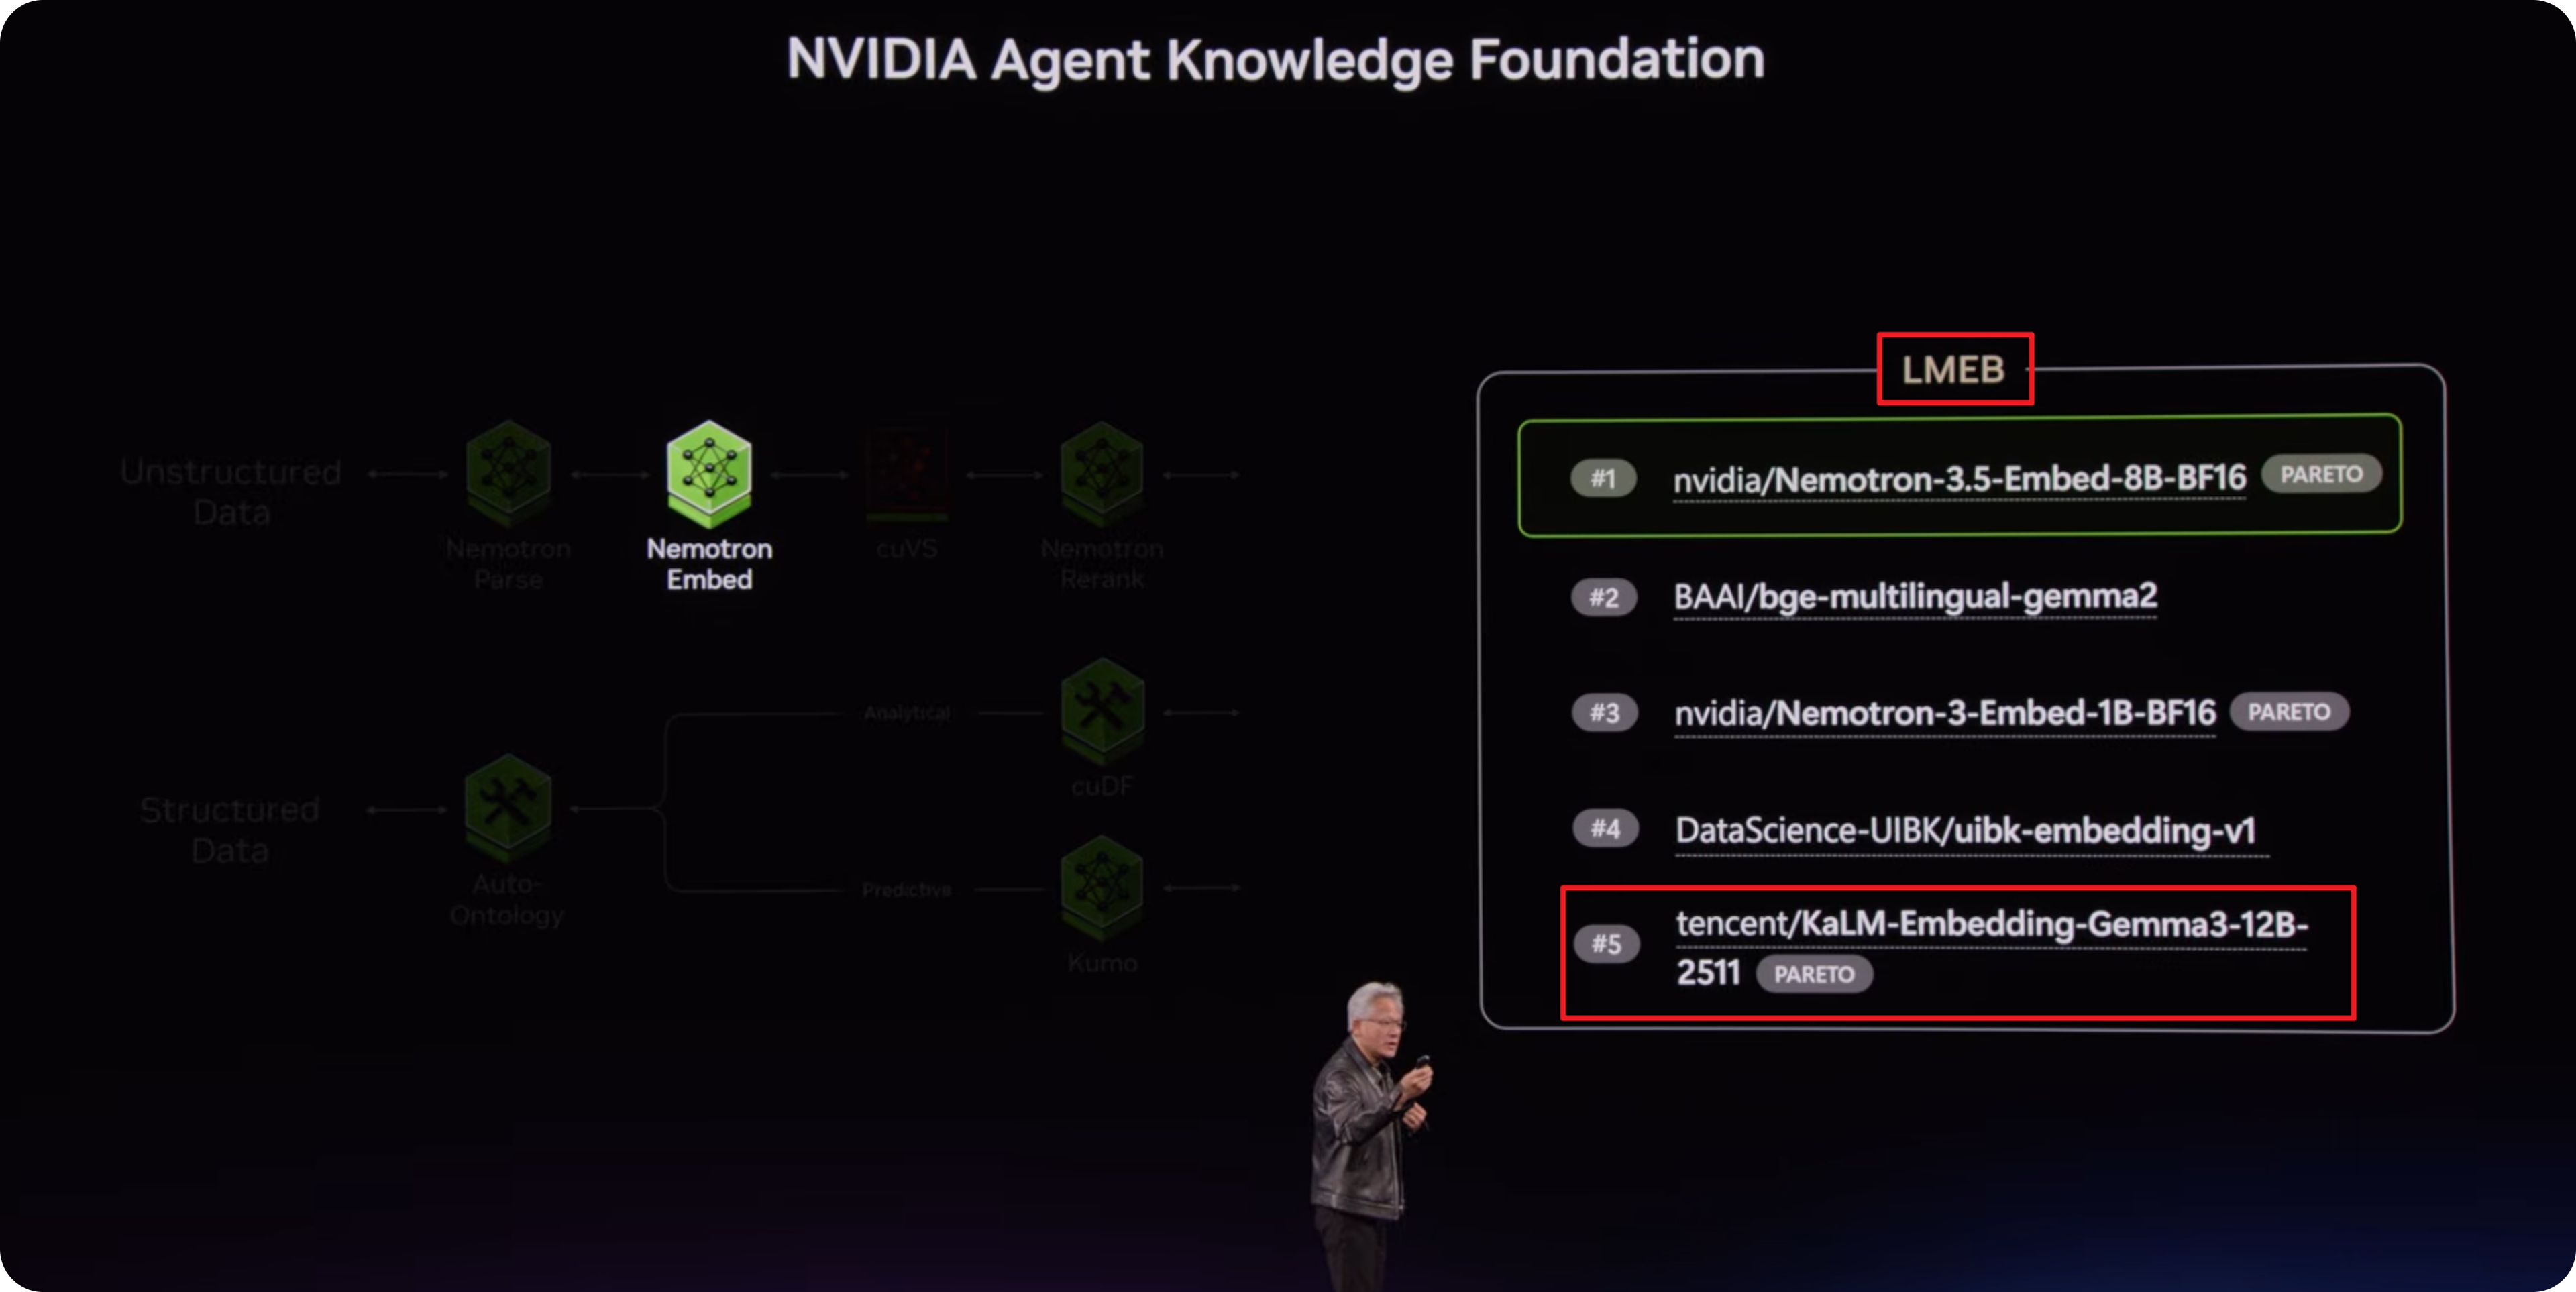
图1 LMEB登上NVIDIA GTC Berlin 2026官方主题演讲
LMEB(Long-horizon Memory Embedding Benchmark)由深圳河套学院、哈尔滨工业大学(深圳)联合团队提出。依托深圳河套学院AI训练平台,团队聚焦智能体长期交互与跨会话场景中的记忆需求,构建覆盖四类记忆场景的统一、可复现的长程记忆嵌入评测体系,揭示通用检索评测难以充分反映的模型能力差异,为智能体记忆系统的模型选型与持续优化提供量化依据。
01 获NVIDIA采用,亮相GTC主题演讲
此前,NVIDIA AI全球官方账号公布了Nemotron 3 Embed系列模型在LMEB上的评测成绩,并说明了该基准的作用:评估嵌入模型在长期会话等记忆密集型场景中找回关键细节的能力。该能力有助于智能体跨会话调用历史信息,支撑持续交互与长期服务。
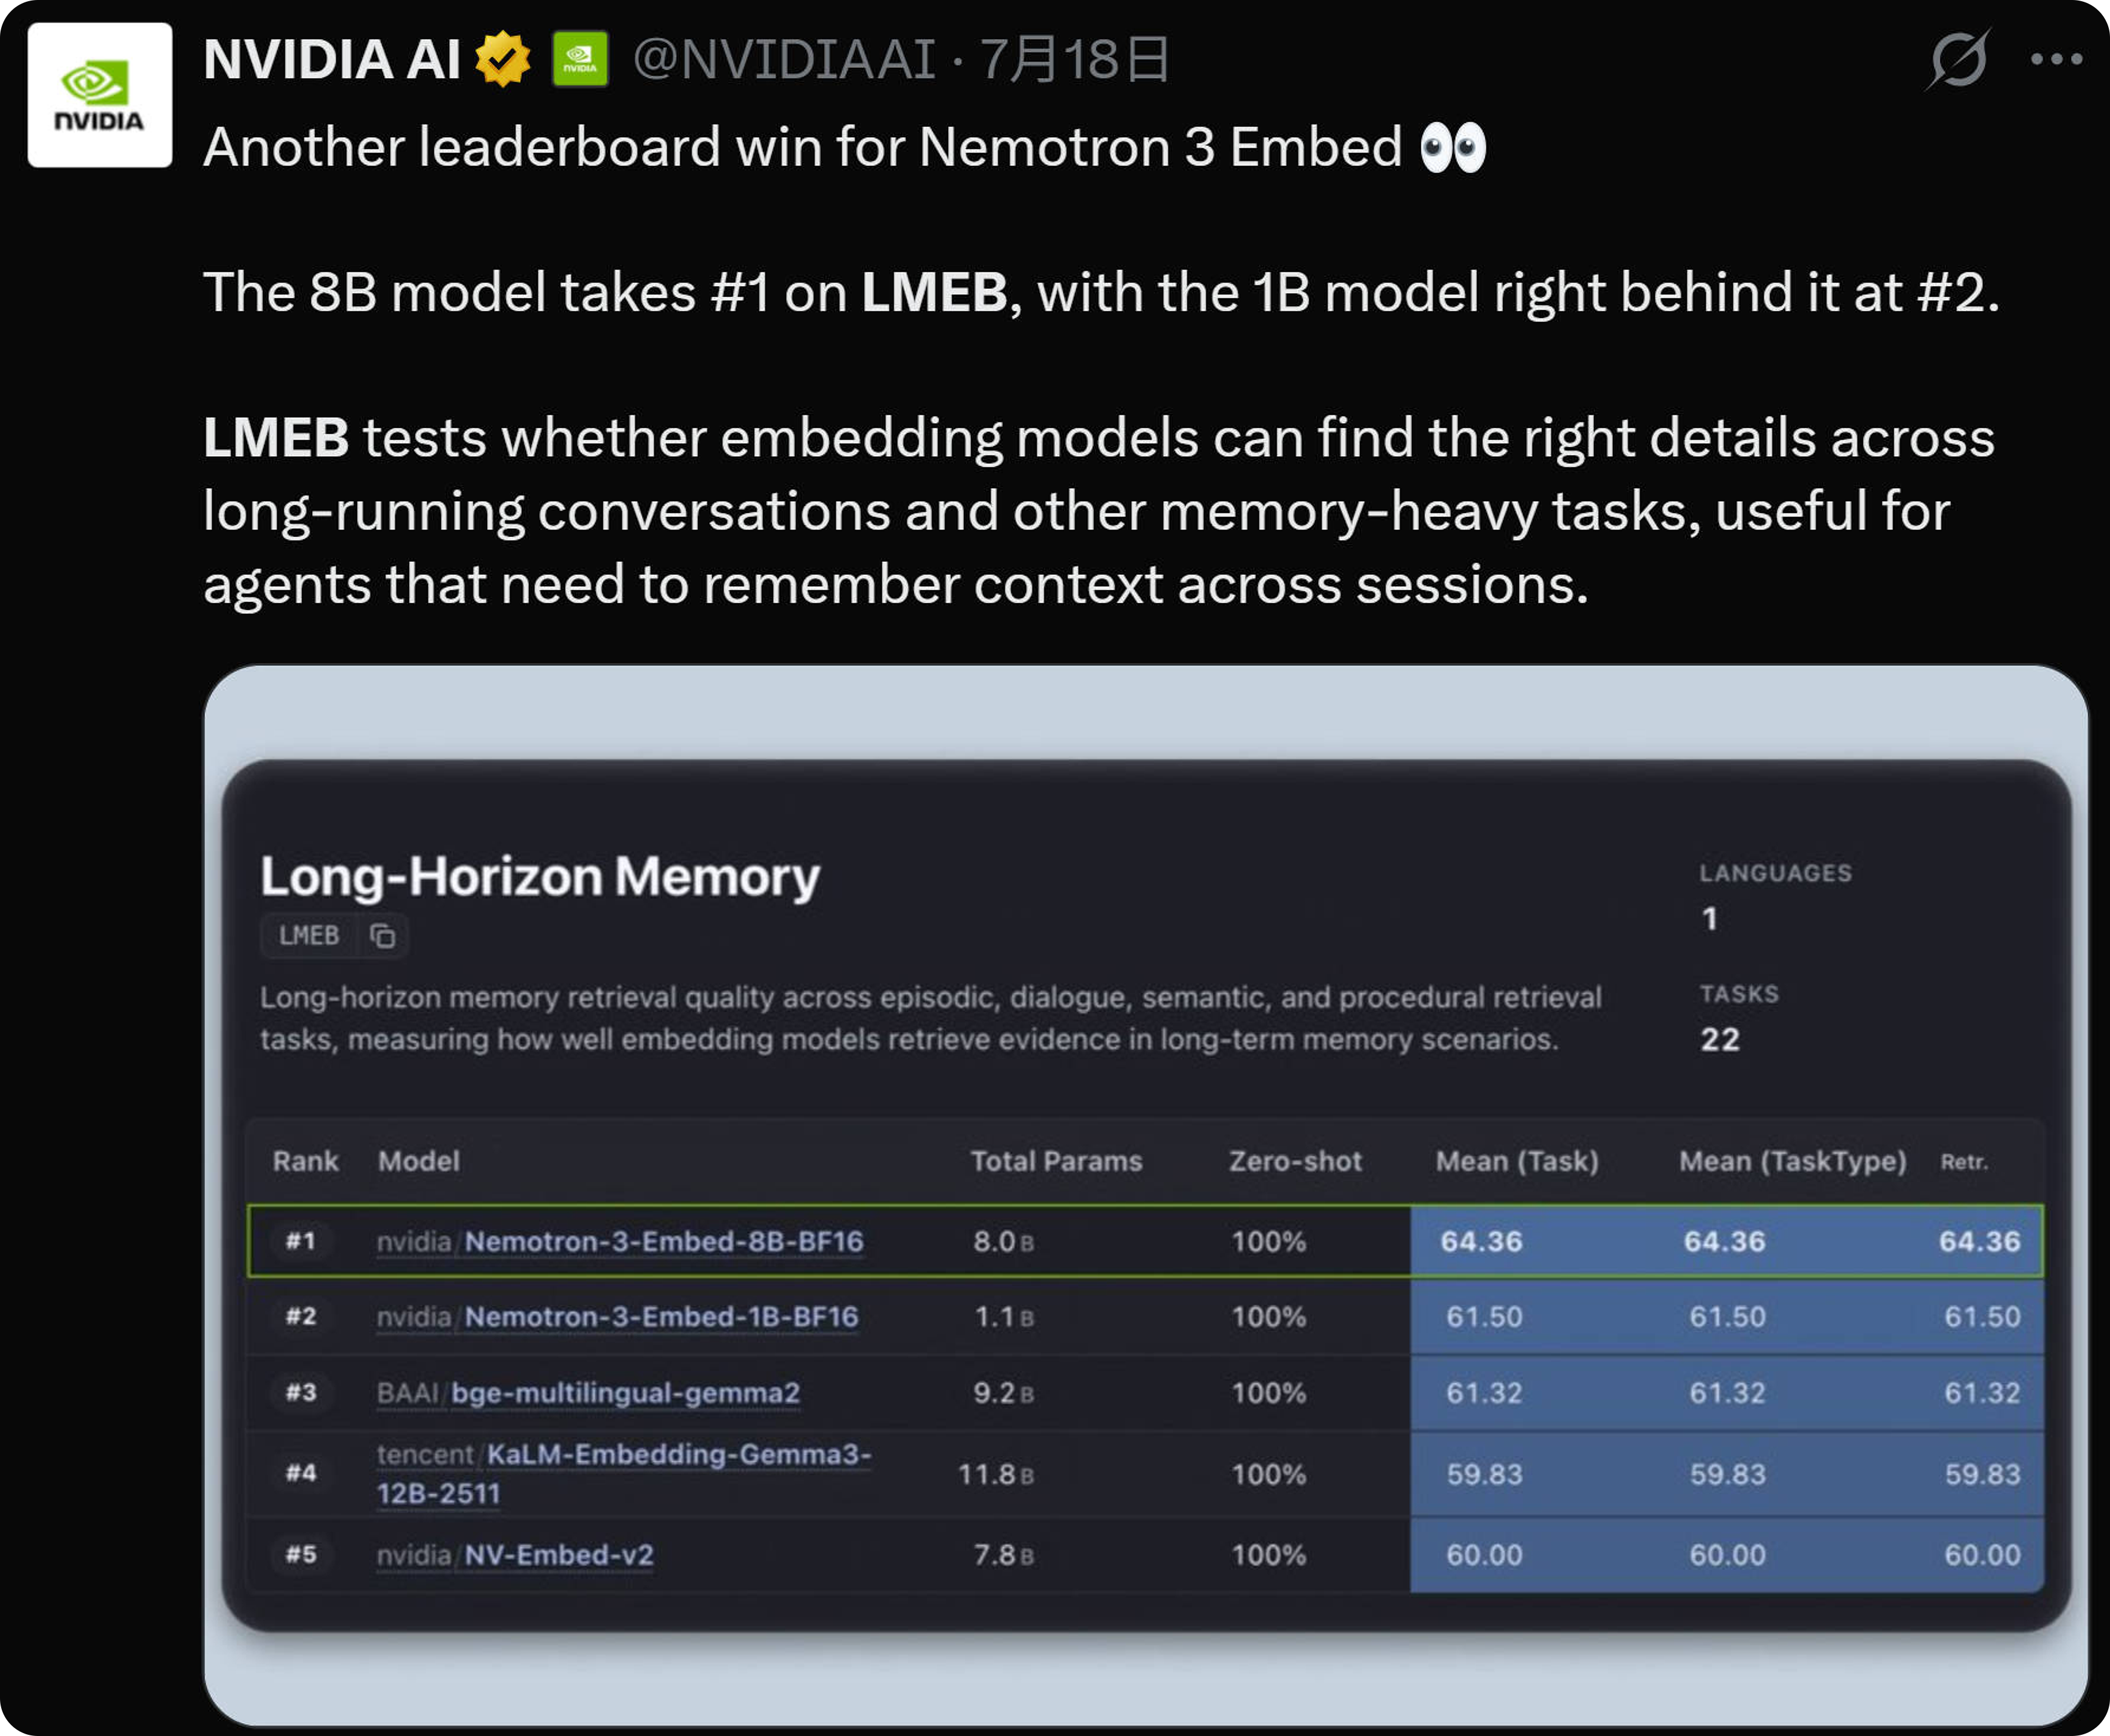
图2 NVIDIA AI官方账号公布Nemotron 3 Embed的LMEB成绩
在随后的NVIDIA GTC Berlin 2026官方主题演讲中,LMEB榜单被用于“NVIDIA Agent Knowledge Foundation(智能体知识基础)”部分的嵌入模型性能展示。联合团队研发的KaLM-Embedding-Gemma3-12B-2511也位列其中,评测基准与模型成果共同呈现在NVIDIA的官方技术展示中。
从NVIDIA的官方账号公布成绩,到GTC主题演讲展示榜单,LMEB在产业模型评测中的实际价值得到体现。通过统一的任务与指标,LMEB为长程记忆嵌入能力的比较提供了共同依据,使产业团队能够直接复用开放研究成果,开展模型评估与优化。
02 为什么需要长程记忆嵌入基准
用户几周前表达的偏好,智能体还能准确找回吗?一项任务分多次推进时,它能否接续此前的进展、调用积累的经验?随着智能体从单次问答走向长期协作,准确找回并利用历史信息,正成为支撑其持续服务的重要能力。
嵌入模型是构建智能体记忆系统的重要基础。它将当前需求与历史信息转化为可计算的向量表示,帮助系统从大量记忆中定位相关证据,为智能体理解前情、衔接任务和复用经验提供关键依据。嵌入表示的质量,直接影响这些记忆能否被准确检索。
然而,通用检索中的优异表现,并不必然意味着模型能胜任长程记忆场景。智能体的历史信息往往分散在不同时间、会话与任务阶段,检索时还需结合时间信息、会话边界与上下文线索判断其相关性。LMEB从长程记忆场景的原生特点出发构建评测体系,使嵌入模型在长程记忆场景中的能力差异得到更有针对性的衡量。
03 四类记忆统一评测,揭示模型能力差异
LMEB将情景记忆、对话记忆、语义记忆和程序性记忆纳入统一评测,覆盖22个英文数据集、193项零样本检索任务,汇集约15.9万条查询与207.7万条候选记忆。**评测内容涵盖历史事件、对话细节、知识事实与任务经验等,系统考察嵌入模型在不同记忆场景下的信息检索能力。
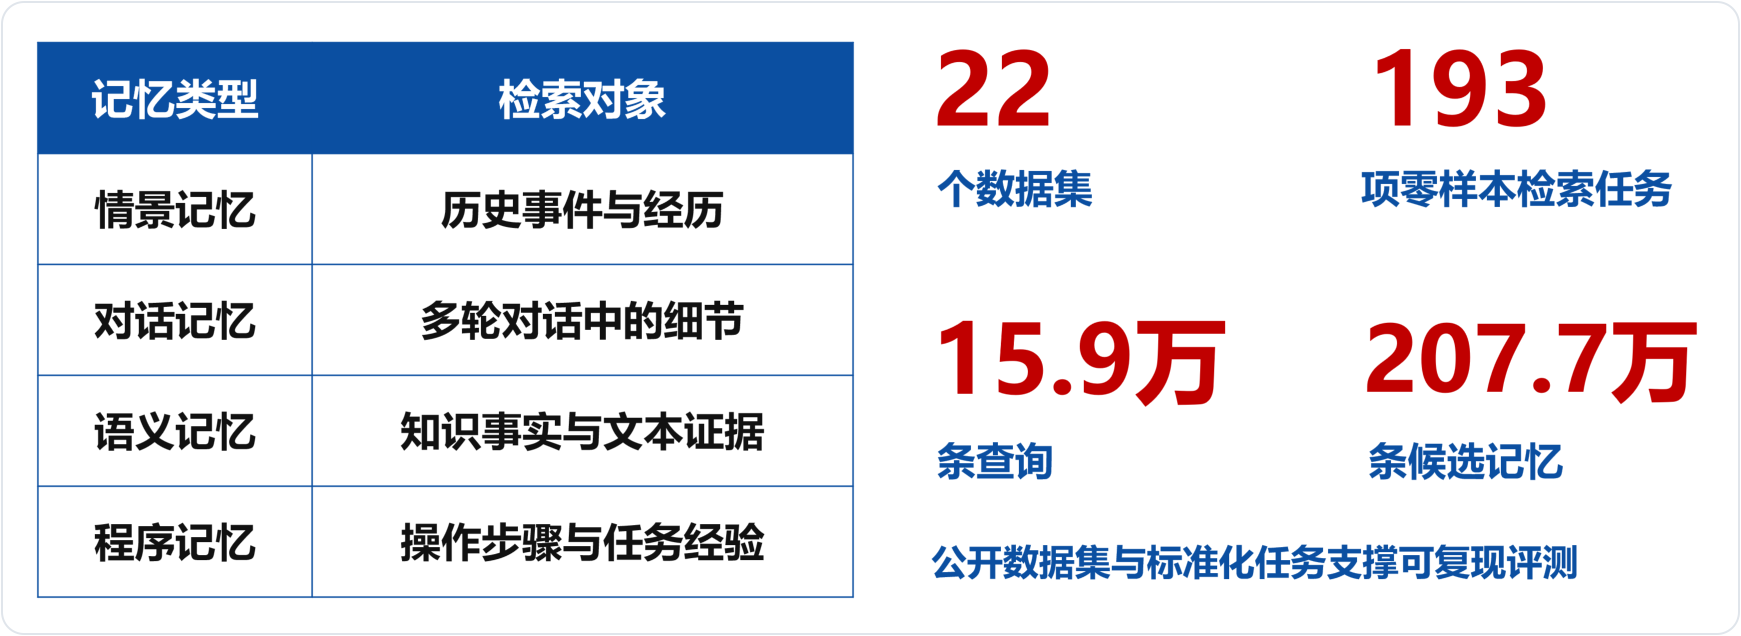
图3 LMEB的四类记忆与评测规模
评测结果显示,模型在不同记忆类型上的相对优势并不一致;同时,LMEB成绩与MTEB英文检索子集成绩仅呈弱相关。这表明,通用检索评测难以充分反映模型在长程记忆嵌入能力上的差异。
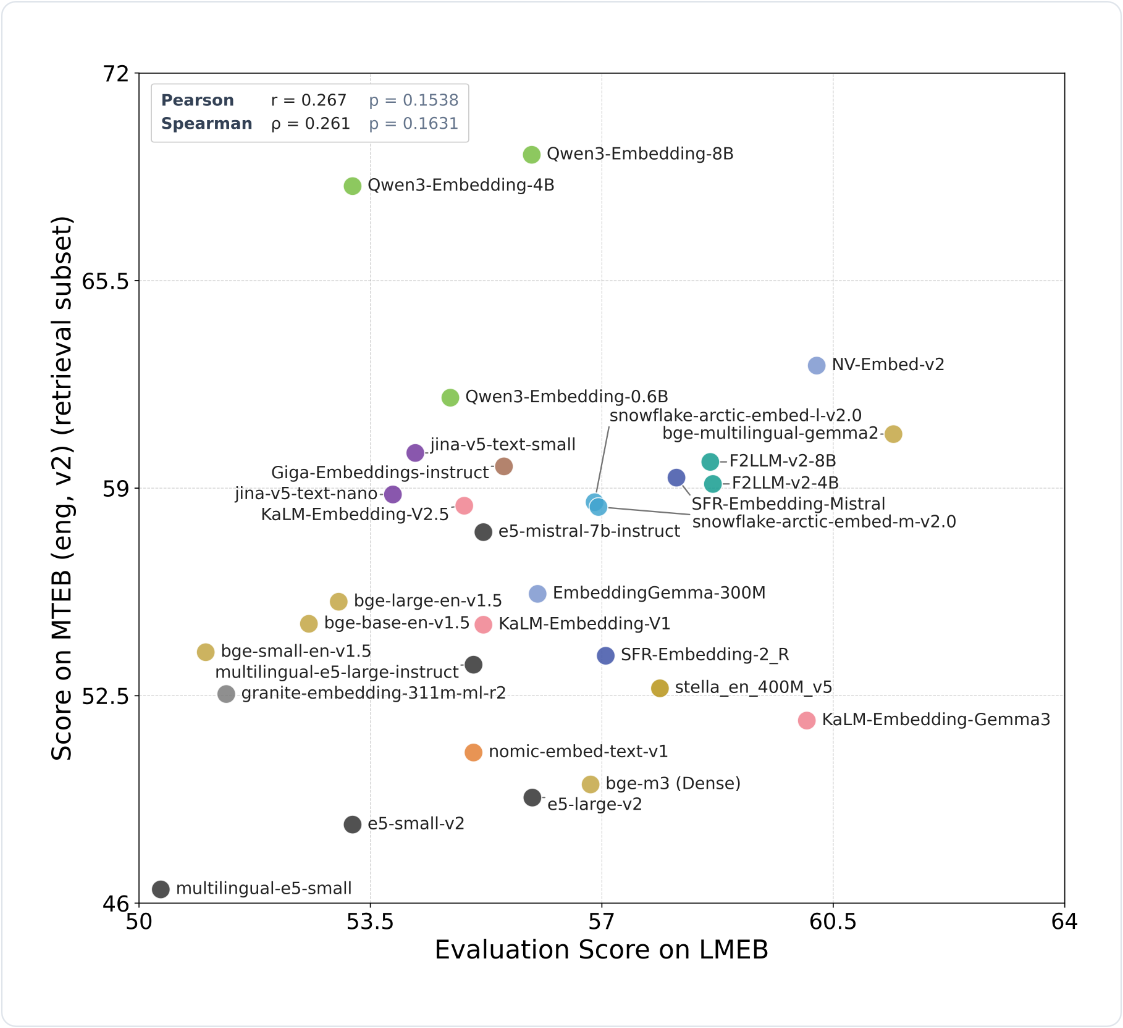
图4 LMEB与MTEB英文检索子集的成绩相关性
通用检索榜单上的优势,并不必然转化为长程记忆场景中的优势。LMEB按记忆类型给出评测结果,帮助开发者结合实际需求识别模型优势与局限,为智能体记忆系统的模型选型提供更具针对性的依据。
04 LMEB × MTEB:构建长程记忆嵌入开放评测生态
LMEB已开放数据与评测工具,支持通过统一接口开展评测,让不同模型在一致的任务、指标和流程下进行比较。该基准已接入国际主流嵌入评测框架MTEB(Massive Text Embedding Benchmark),方便社区复现结果、开展比较和接入新模型。
目前,公开榜单已覆盖NVIDIA、Qwen、BGE、KaLM等系列的100余款嵌入模型。通过比较不同年份发布的模型,LMEB展示了长程记忆嵌入能力的演进,为研究者追踪技术进展、开发者比较模型方案提供参照。下图中绿色折线表示截至各时间点已发布模型的最高成绩。
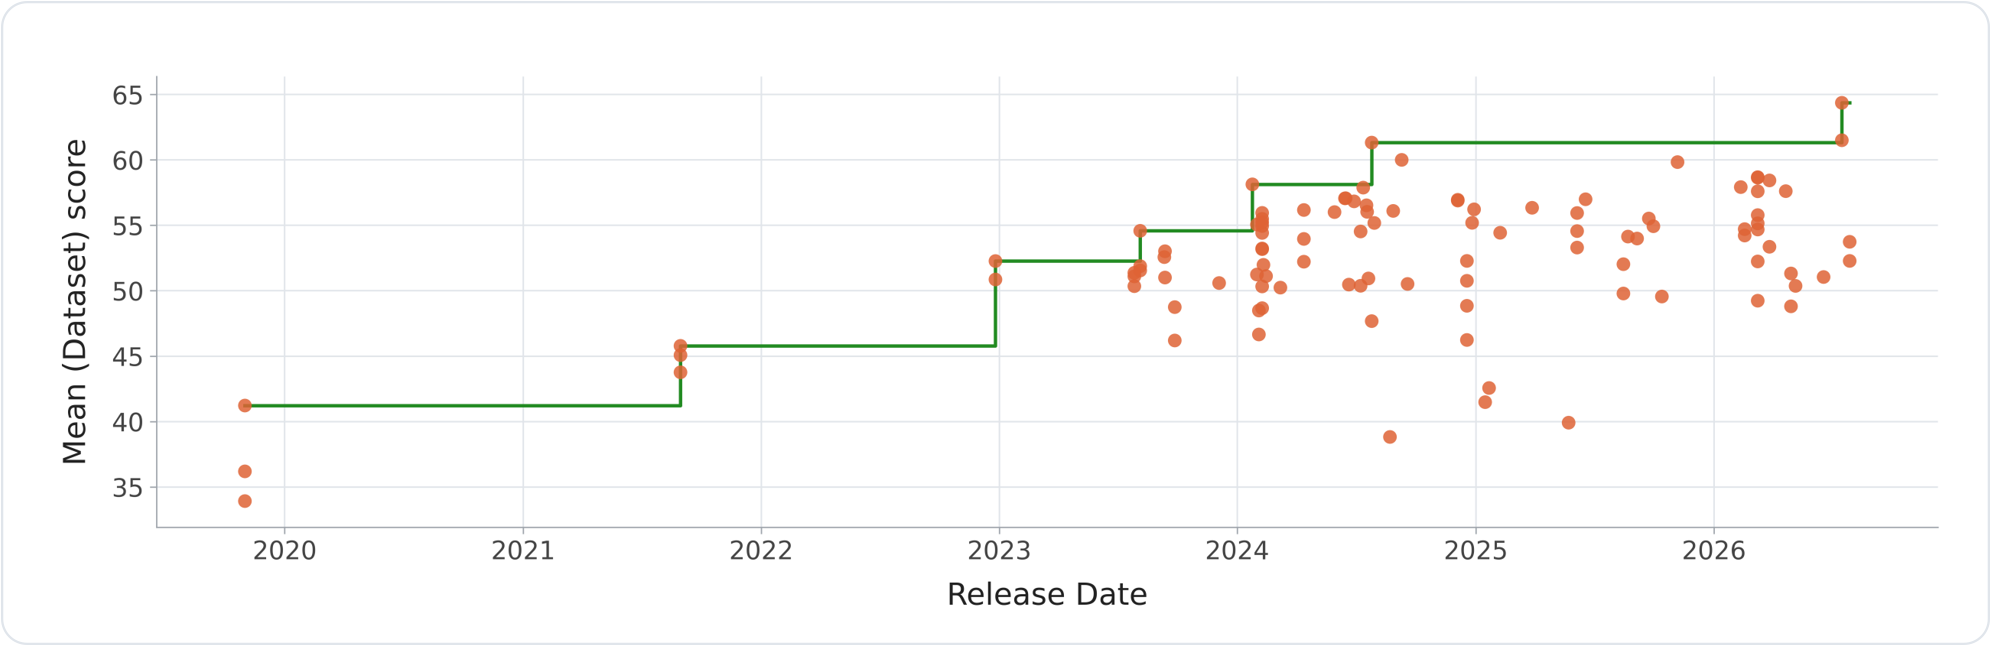
图5 100余款嵌入模型的LMEB成绩与发布时间
完成环境配置后,以KaLM-embedding-multilingual-mini-instruct-v2.5为例,仅需几行核心代码,即可启动LMEB评测。
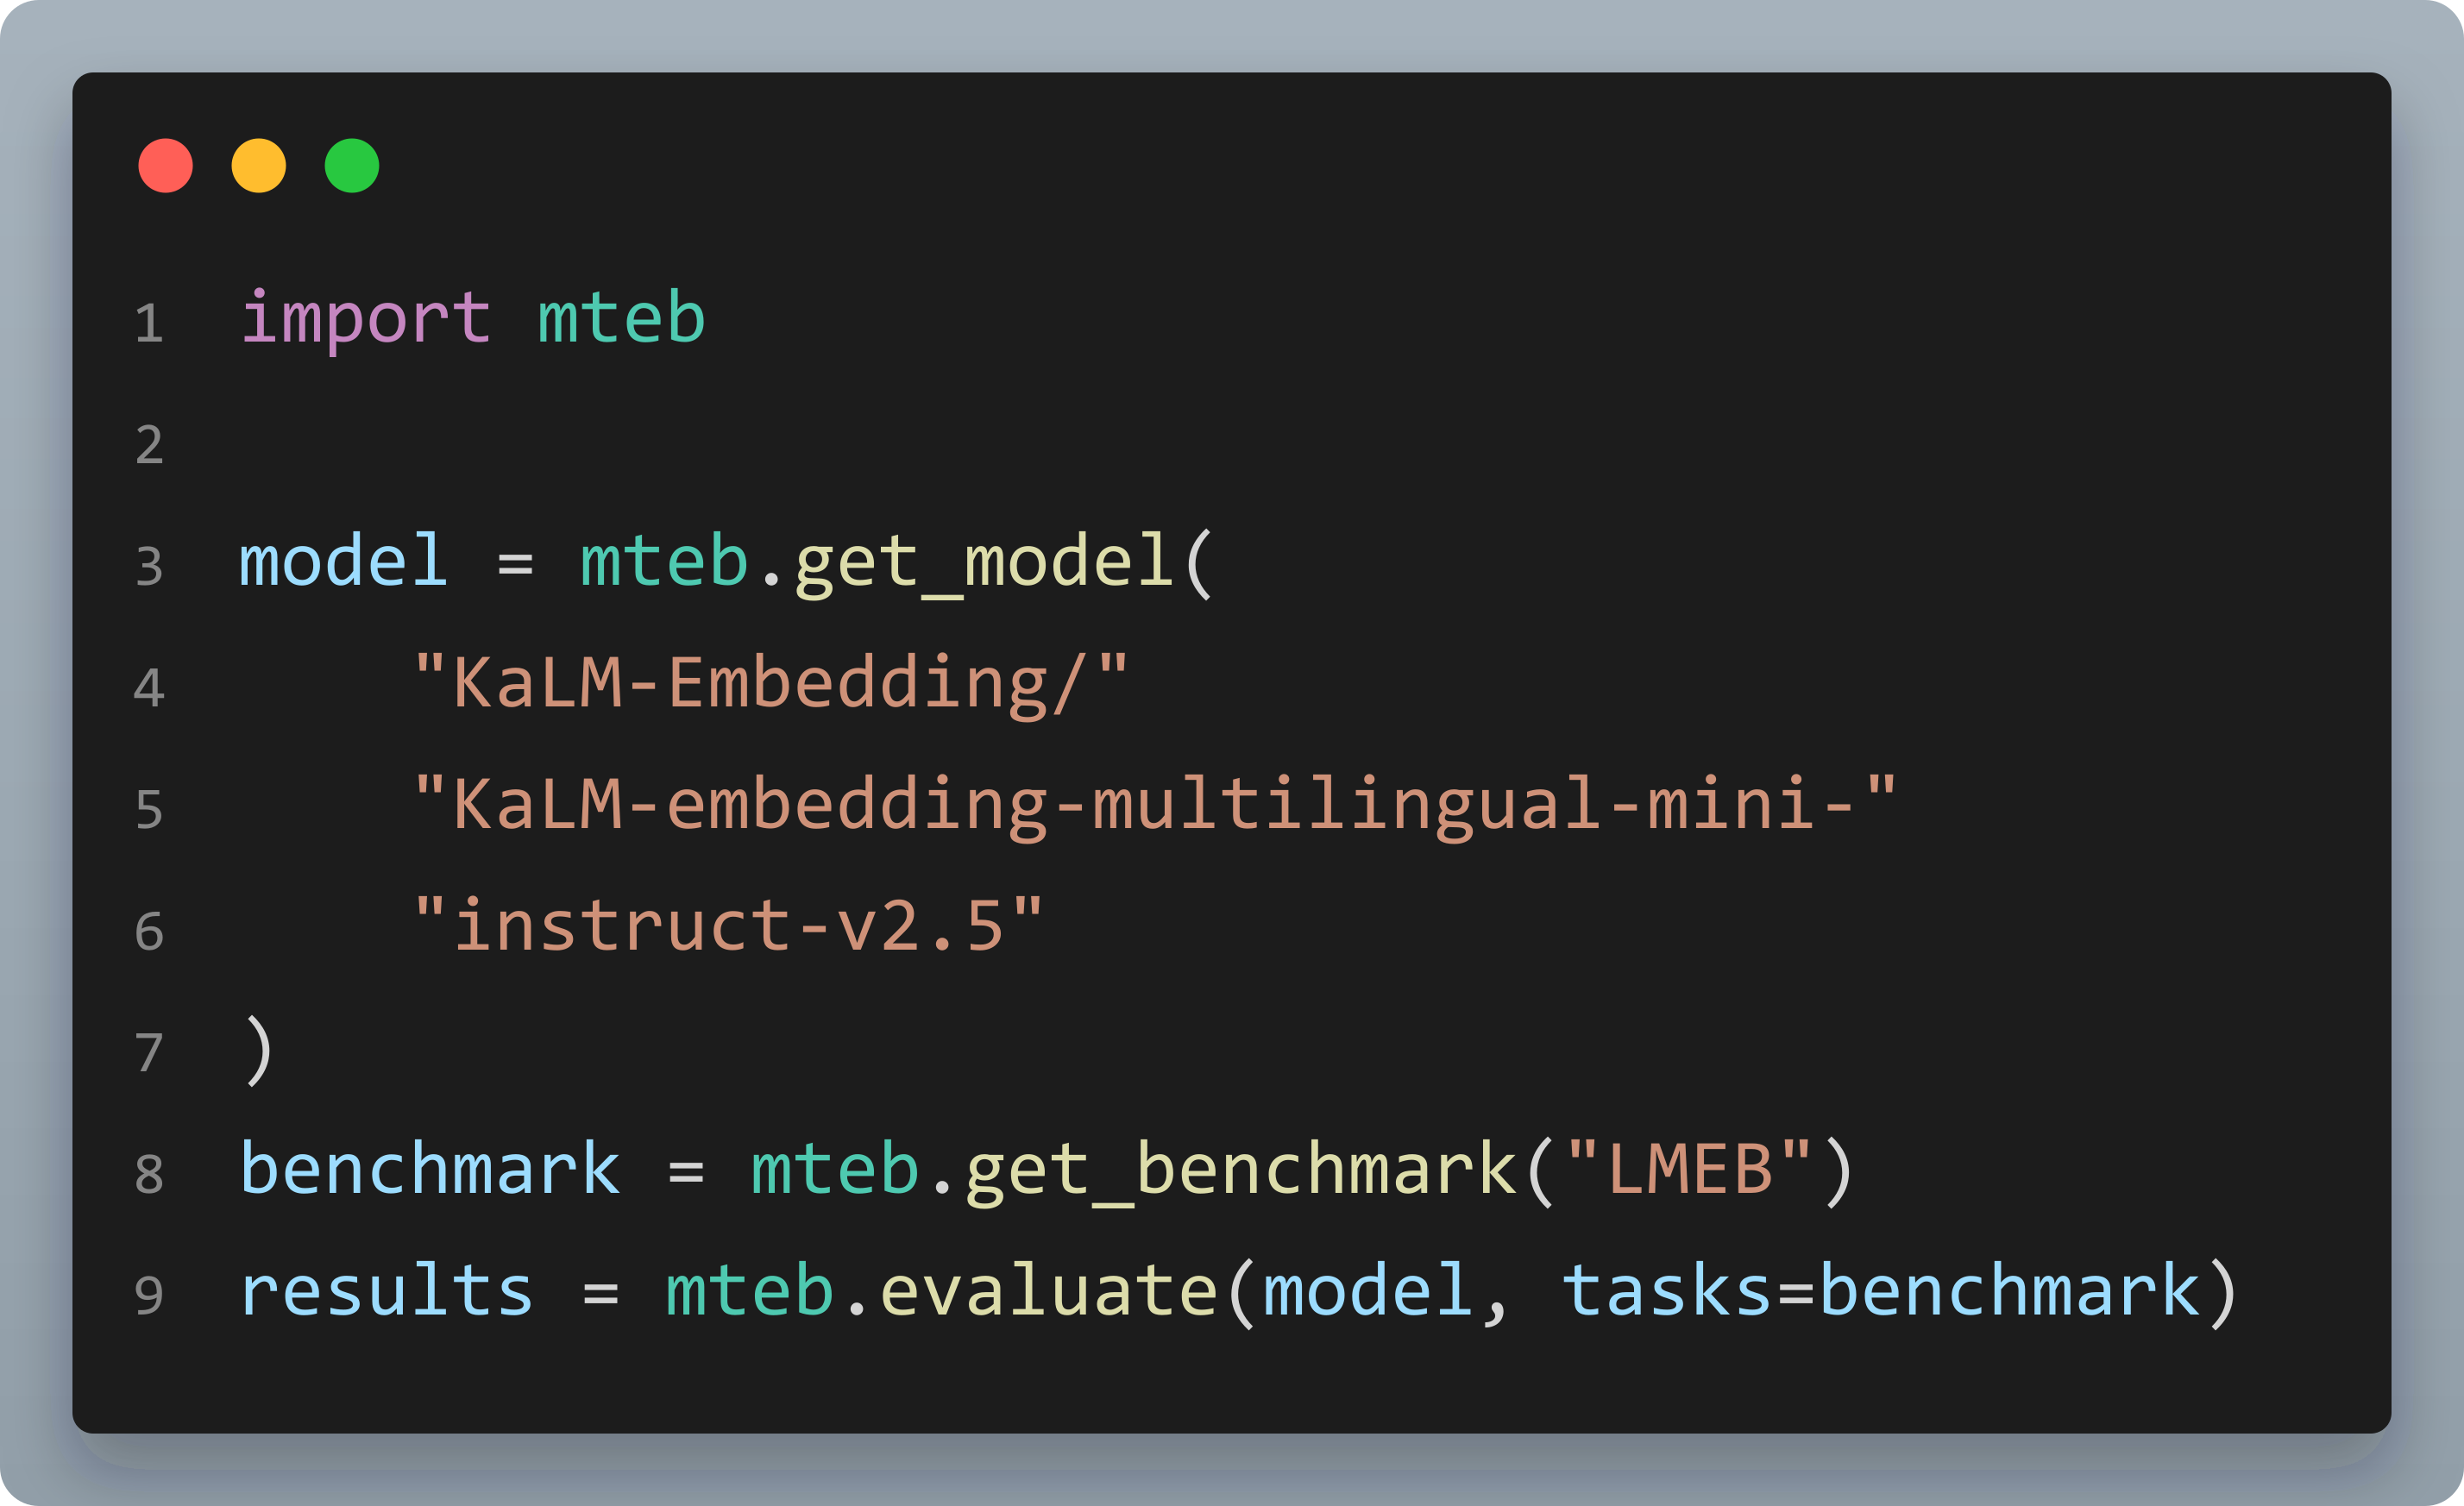
图6 KaLM-embedding-multilingual-mini-instruct-v2.5的LMEB评测示例
统一接口与配套工具降低了评测的接入与复现成本。研究者可以更便捷地检验新模型,开发者可以围绕应用需求比较方案;社区也可在此基础上持续补充模型结果、扩展评测任务,推动长程记忆嵌入模型的验证与改进。
05 嵌入与重排序:从开源走向应用
KaLM-Embedding系列的代表模型曾登顶多语言MTEB全球榜单。截至2026年11月1日,纳入统计的6个官方模型仓库在Hugging Face平台上的累计下载量超过175万次。相关模型已应用于微信搜索、微信公众号等业务场景,并通过腾讯云对外提供商业化文本向量化服务,形成从模型开源到业务应用与云端服务的落地路径。
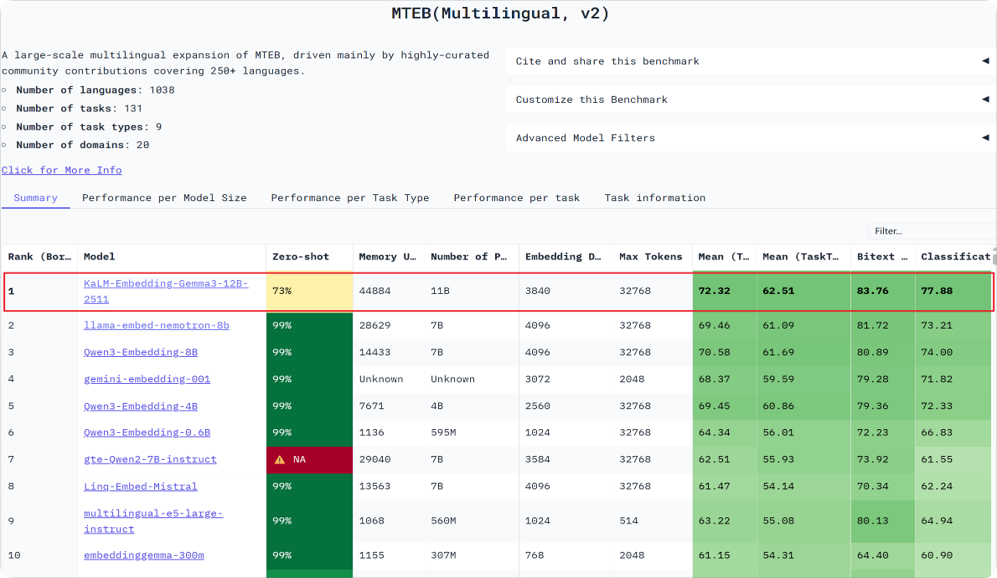
图7 KaLM-Embedding代表模型登顶多语言MTEB榜单
Lychee-Reranker(原名KaLM-Reranker)提出“Fast but Not Late Interaction(FBNL)”高效重排序范式,利用动态测试时计算与极致文档压缩降低在线文档重排序开销,在排序质量与推理效率之间取得平衡。该系列已获主流开源框架Sentence Transformers集成支持,开发者可通过统一接口调用,将其接入检索增强生成系统。
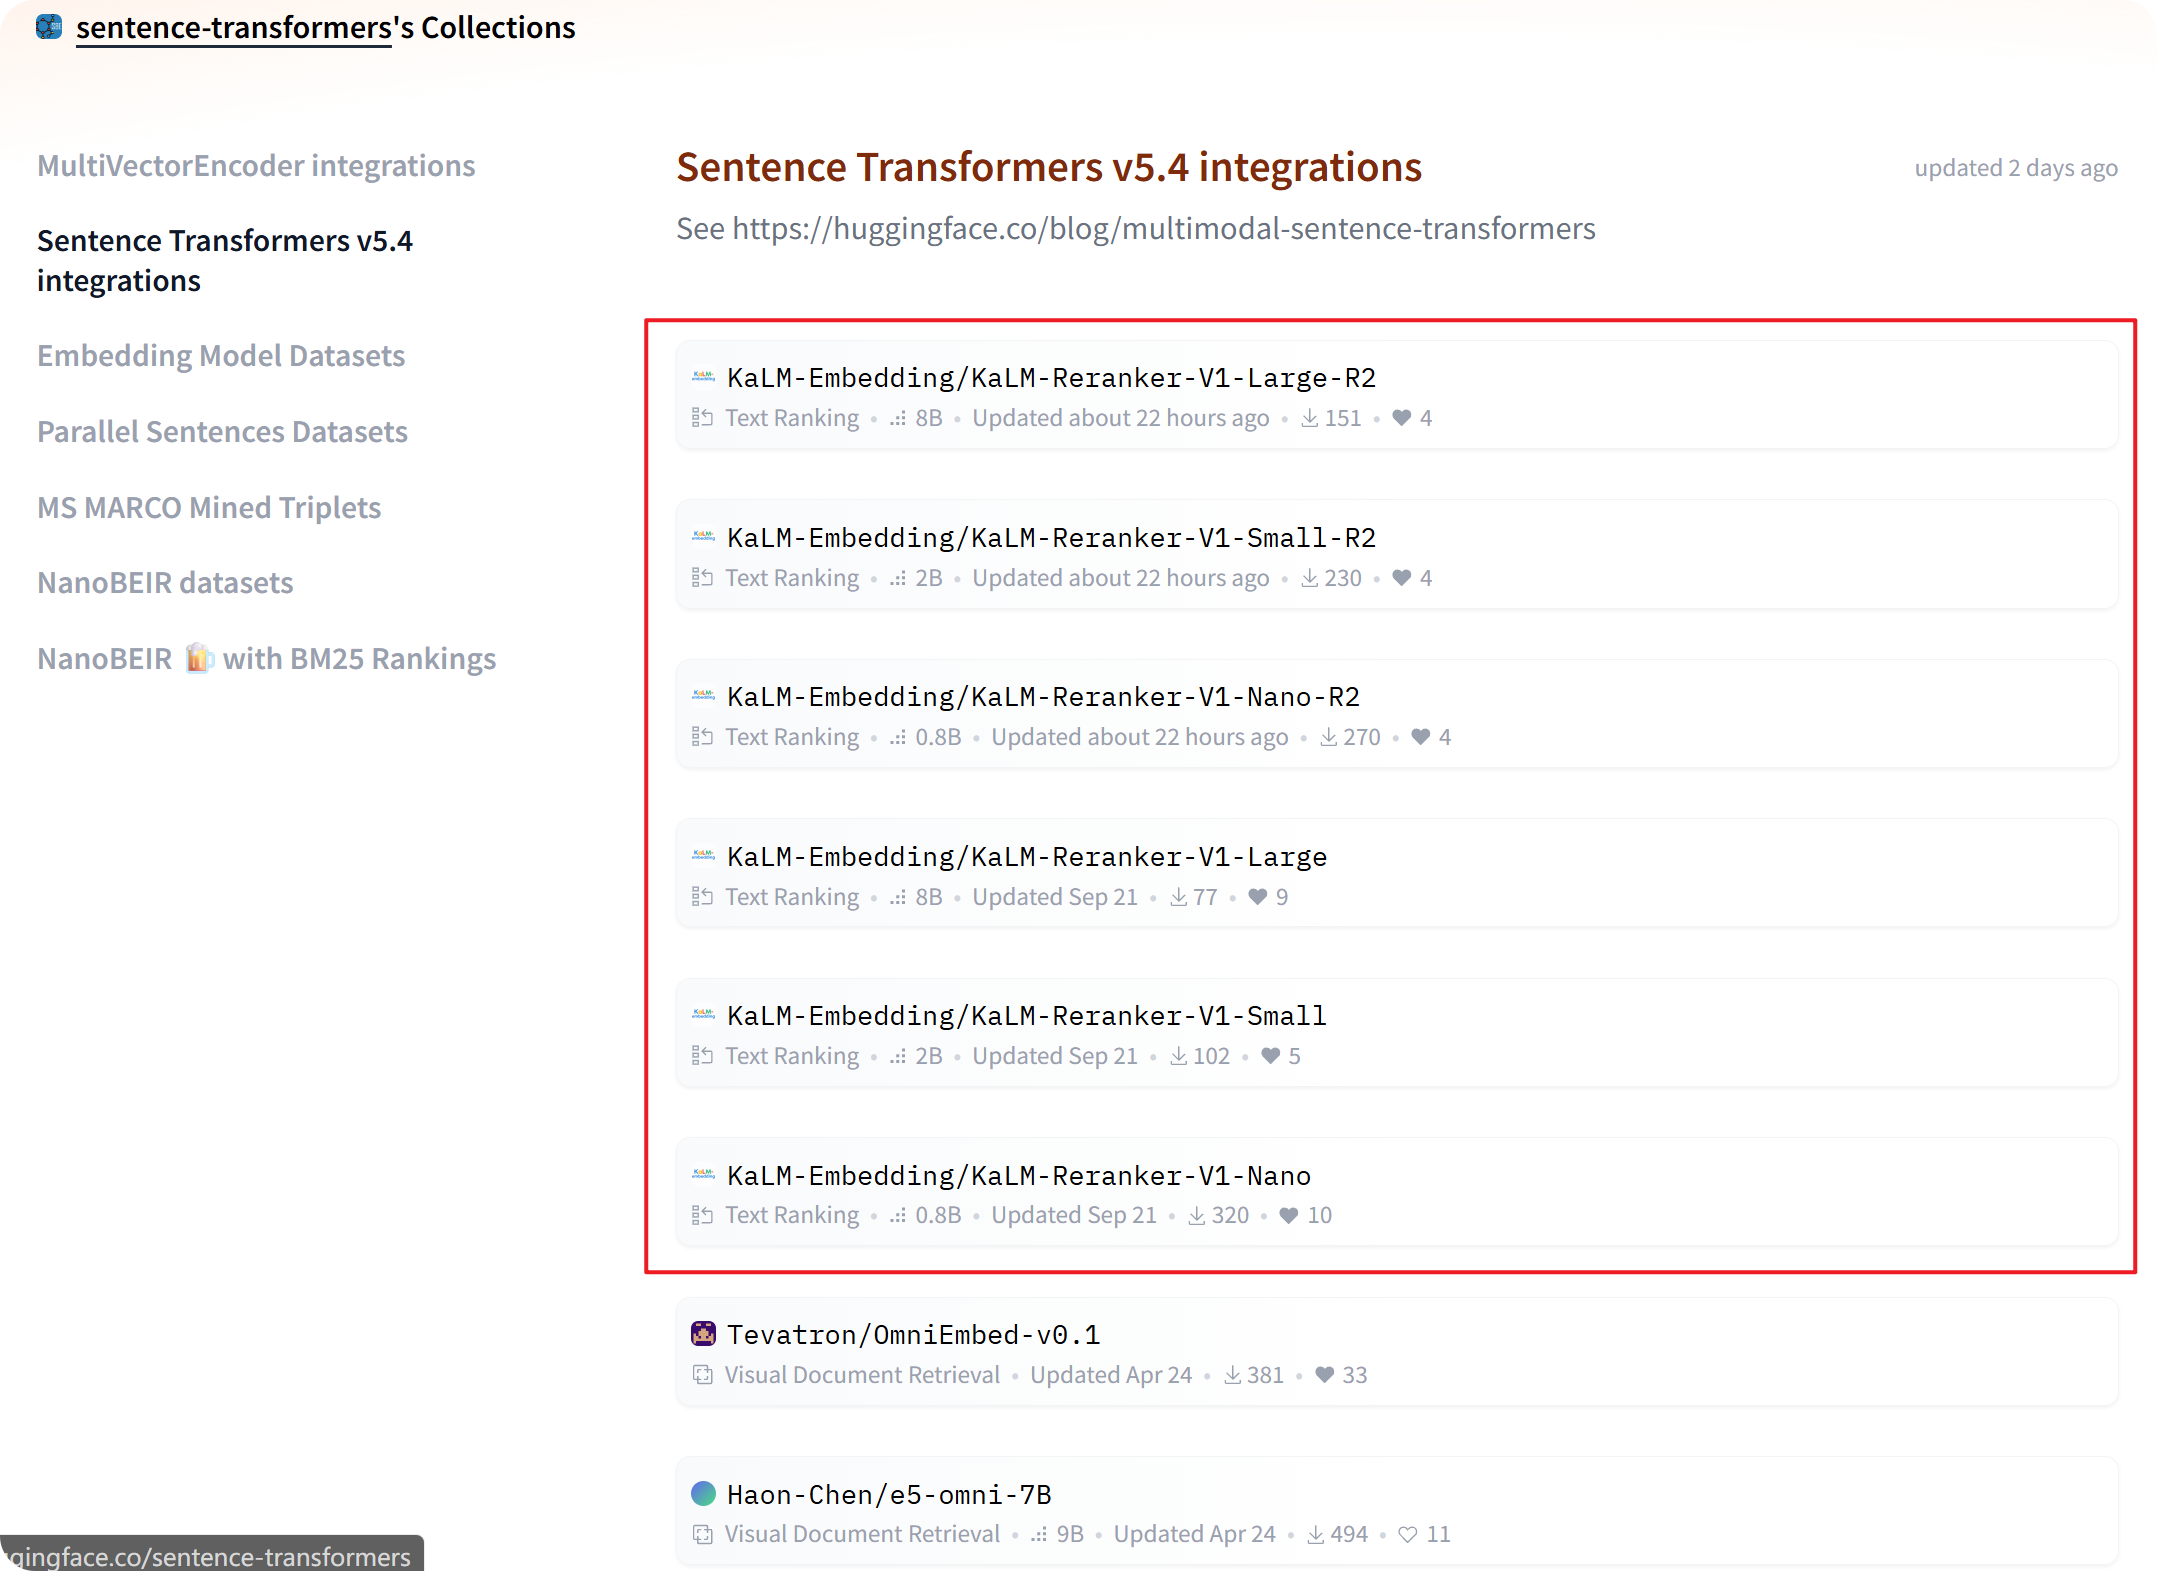
图8 Lychee-Reranker(原名KaLM-Reranker)接入Sentence Transformers
Sentence Transformers负责人、Hugging Face工程师Tom Aarsen公开介绍了该系列模型的多语言重排序与文档压缩能力,并通过代码示例演示调用方式,帮助社区开发者将其接入实际系统流程。
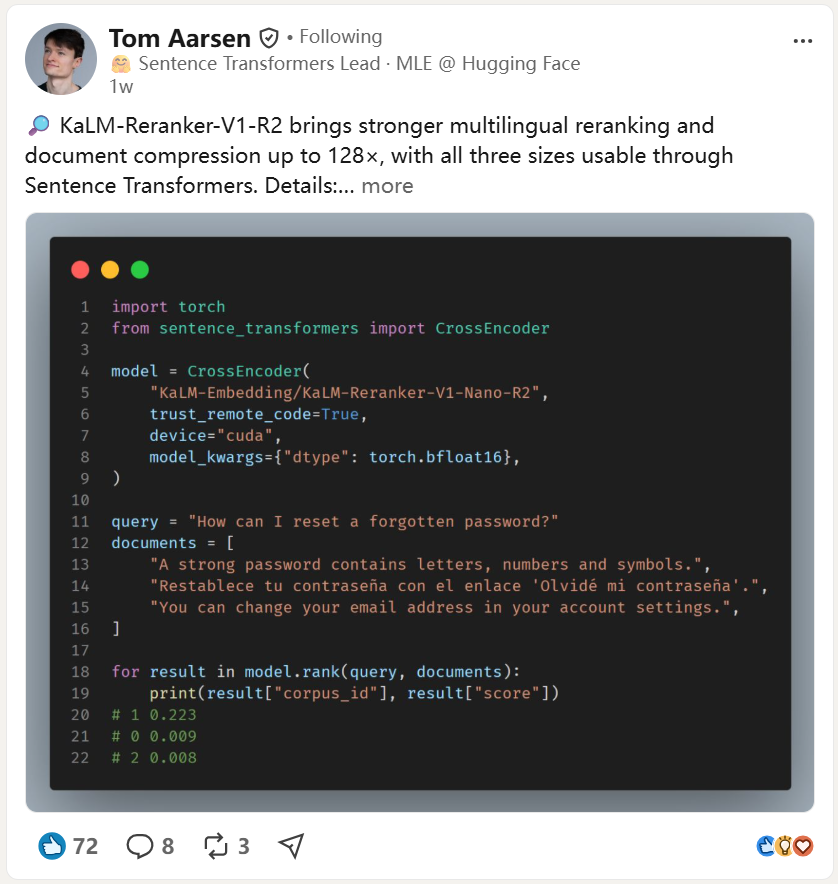
图9 Sentence Transformers负责人对KaLM-Reranker-V1-R2的介绍与调用示例
06 构建面向大模型的智能检索与知识应用技术底座
依托深圳河套学院AI训练平台,团队自主研发了通用文本嵌入模型、高效重排序模型与检索增强生成系统,构建了完整的面向大模型的智能检索与知识应用技术底座。其中,KaLM-Embedding提供通用文本表示能力,Lychee-Reranker提供兼顾高效推理与细粒度交互的重排序能力,LMEB提供面向长程记忆嵌入的统一基准,三者协同支撑模型研发、能力评估与应用验证。
团队同步开放模型、数据集与评测工具,将研究成果转化为社区可复用、可验证、可扩展的技术资源,支持研究者检验新方法,也方便开发者集成与优化系统。该技术底座连接模型创新、评测验证与应用需求,为智能体在长期交互中检索历史信息、复用任务经验和应用知识提供基础支撑。
联合研究团队与论文信息
联合团队:
深圳河套学院、哈尔滨工业大学(深圳)
论文:
LMEB: Long-horizon Memory Embedding Benchmark
论文作者:
Xinping Zhao, Xinshuo Hu, Jiaxin Xu, Danyu Tang, Xin Zhang, Mengjia Zhou, Yan Zhong, Yao Zhou, Zifei Shan, Meishan Zhang, Baotian Hu, Min Zhang
通讯作者:
Baotian Hu
平台支撑:
深圳河套学院AI训练平台
相关链接
LMEB论文:
https://huggingface.co/papers/2603.12572
LMEB数据与评测资源:
https://huggingface.co/collections/KaLM-Embedding/lychee-kalm-lmeb-and-mteb-lmeb
LMEB公开榜单:
https://mteb-leaderboard.hf.space/benchmark/LMEB
MTEB评测框架:
https://github.com/embeddings-benchmark/mteb
KaLM-Embedding模型集合:
https://huggingface.co/collections/KaLM-Embedding/lychee-kalm-embedding
Lychee-Reranker模型集合:
https://huggingface.co/collections/KaLM-Embedding/lychee-kalm-reranker-and-jev
腾讯云文本向量化服务:
https://intl.cloud.tencent.com/zh/document/product/845/78876
NVIDIA主题演讲: