TrainBridge全新上线!融通GPU优化经验,释放国产算力训练性能
导读
国产算力训练模型,如何从“跑得通”迈向“跑得快”?深圳河套学院联合智子芯元与华为推出模型自动训练优化工具TrainBridge,提出一种新思路:让agent借鉴GPU上成熟的编译优化经验,在昇腾NPU上进一步优化,可加速1.7-2倍。
01 从“跑得通”到“跑得快”
迁移到昇腾NPU后,训练程序能够正确运行,但训练速度往往不够理想。以社区公认的语言模型预训练基准Modded-NanoGPT的某个版本为例,同样完成一次完整训练,8张英伟达H100 GPU只需128秒,迁移到8张昇腾910C NPU上的初始版本却需要563秒,是GPU的4.4倍。
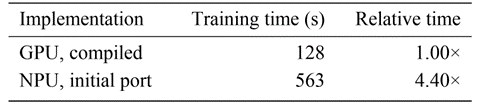
图1 同一训练任务在GPU与NPU上的训练耗时
既然训练程序运行得慢,能不能直接让AI来优化?
研究团队先让通用AI Agent修改训练代码。经过12小时调优,训练耗时从563秒降至平均 419.2秒,但距离理想训练速度仍有较大差距。
如果让Agent借助性能分析工具,先找出最耗时的环节再修改呢?实验发现,这一过程需要反复“分析—修改—运行—验证”,消耗大量的计算资源进行迭代验证,效果提升也比较缓慢。原因在于:最耗时的环节,未必最有提速空间;知道哪里慢,也不等于知道哪里值得改、该怎么改。问题因此变成:能否给Agent一个更明确的优化方向?
02 让GPU编译经验为NPU调优“指路”
那么,如何帮助Agent找到更有潜力的优化方向?答案藏在GPU上。经过多年发展,GPU已经形成成熟的编译优化技术,能够在训练前自动简化计算、合并操作,减少不必要的运行开销。前文提到,GPU完成一次训练只需128秒,这其中编译功不可没:如果关闭编译,同样的训练需要338秒,仅编译一项就带来约2.6倍提速。
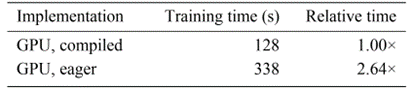
图2 同一训练任务在GPU编译前(eager)与编译后的训练耗时
这些优化经验虽然不能直接用于NPU,却可以为NPU性能调优提供重要参考。基于这一思路,团队提出TrainBridge,分两步帮助 Agent优化NPU训练程序:第一阶段,TrainBridge比较同一训练程序在GPU编译前后的变化,从中找出值得尝试的优化方向,并改写NPU训练程序;第二阶段,Agent借助NPU性能剖析处理剩余瓶颈。
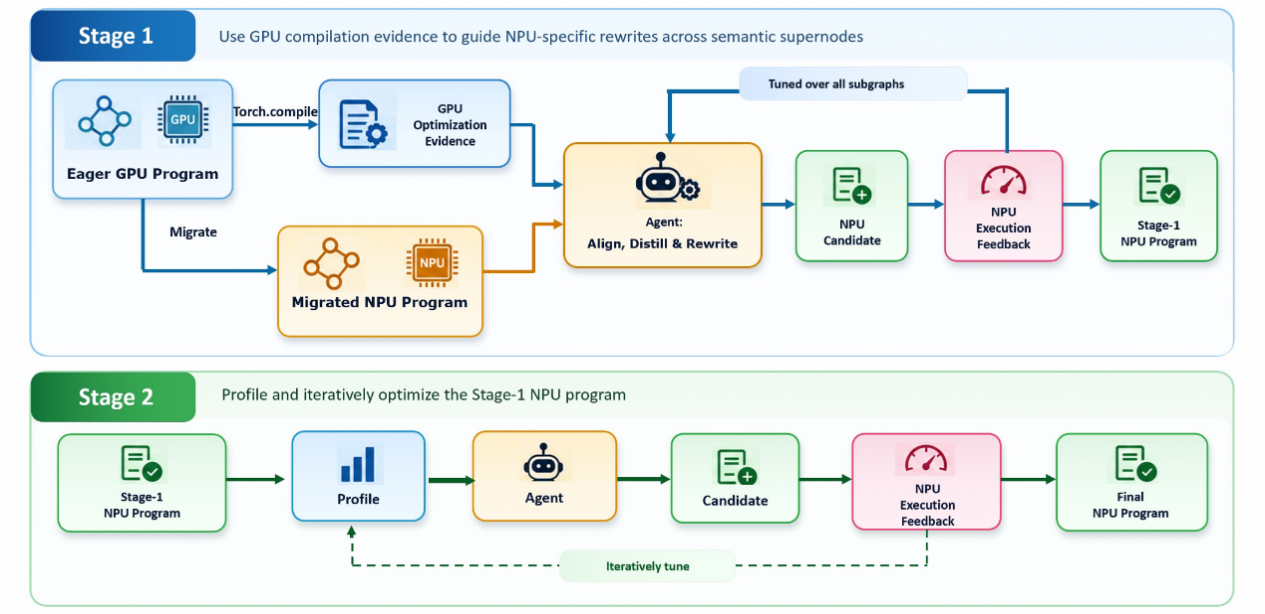
图3:TrainBridge两阶段调优流程
举一个具体例子。在语言模型注意力计算的一个步骤中,原始实现会产生一连串冗余的数据拷贝。GPU编译会自动消除这些拷贝,NPU版本却保留了它们。在TrainBridge引导下,Agent识别出这一优化意图,写出功能等价、去除冗余拷贝的NPU实现,这一步耗时从2.604毫秒降至0.508毫秒,提速5.13倍。
03 实验验证:调优更快,训练也更快
团队在语言模型预训练、图像分类、视觉语言训练等多类任务上对TrainBridge开展了系统性评估。
在采用基准通用AI Agent方案、调优时间相同的对照实验中,只用通用Agent找到的最优训练耗时平均为419.2秒,加入TrainBridge后降至283.2秒,缩短32.4%,显著提升训练调优效率。
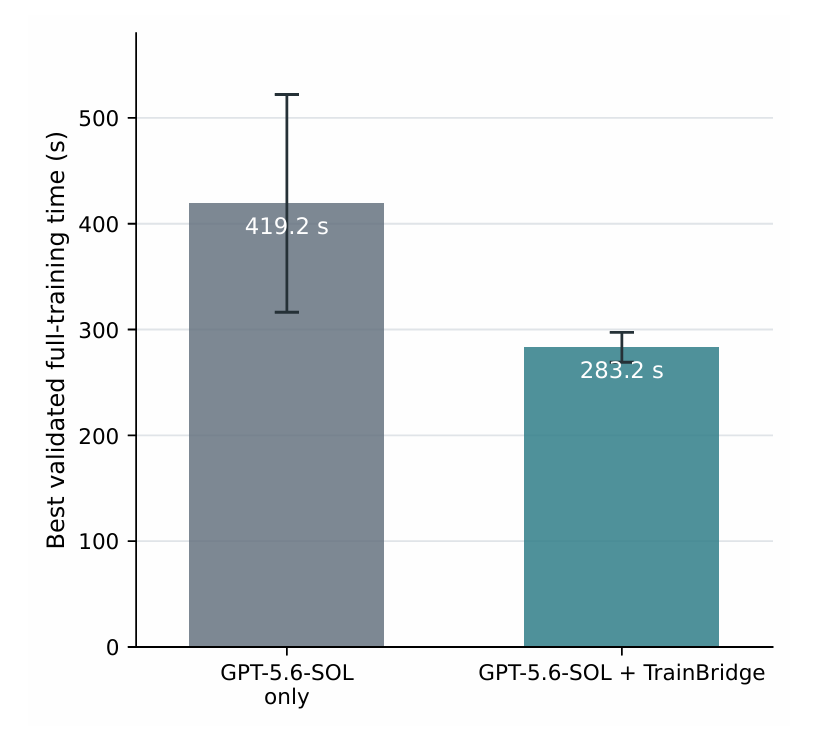
图4 同一通用Agent引入TrainBridge前后的调优效果
在高度优化的预训练语言模型基准上:团队从Modded-NanoGPT前50条历史记录中随机抽取27条,在8张昇腾910C上逐条调优。TrainBridge使NPU训练平均提速1.95倍。
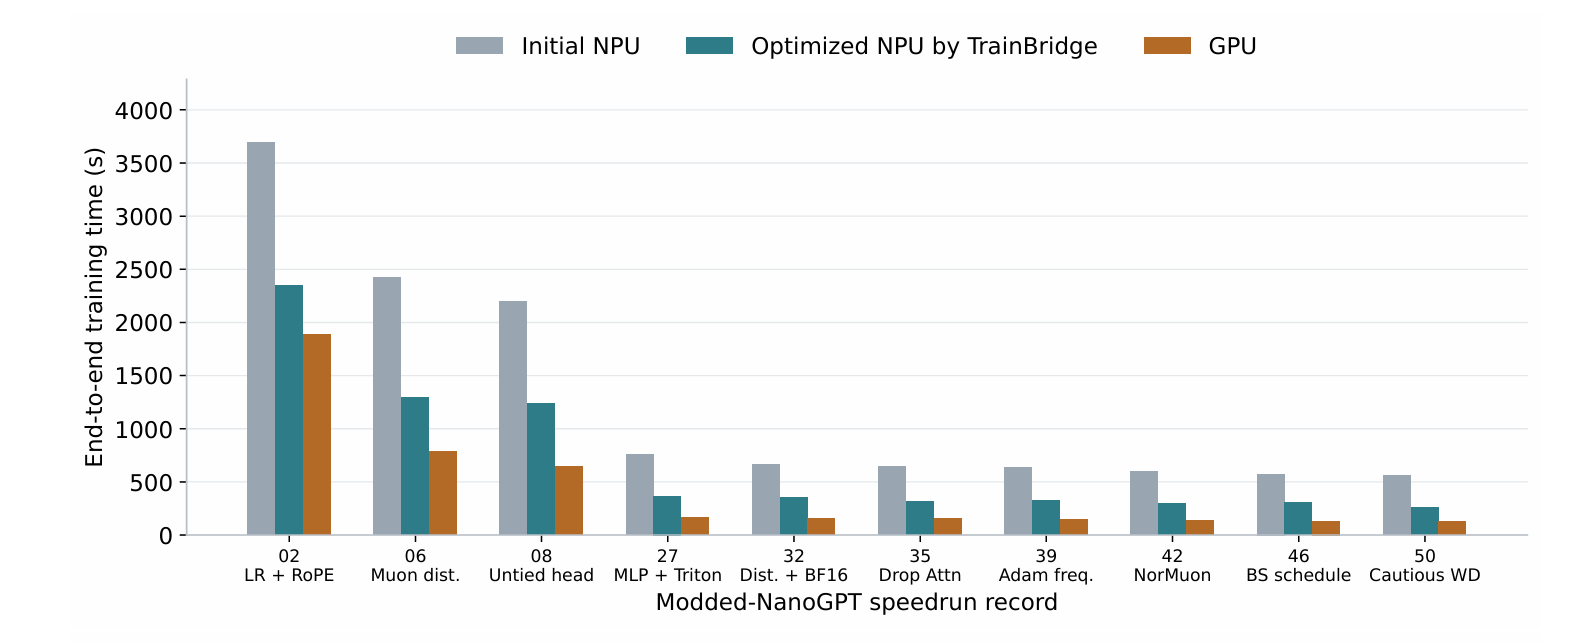
图5 按编号近似均匀抽取的10条记录调优前后的完整训练时间
在多类常见训练任务上:CIFAR-10 AirBench(图像分类训练速度基准)、ViT(基于Transformer的图像分类模型)、Qwen3-0.6B(6亿参数语言模型)和nanoVLM(轻量级视觉语言模型)四项训练任务分别提速2.22倍、1.25倍、1.68倍和1.84倍,平均1.7倍。
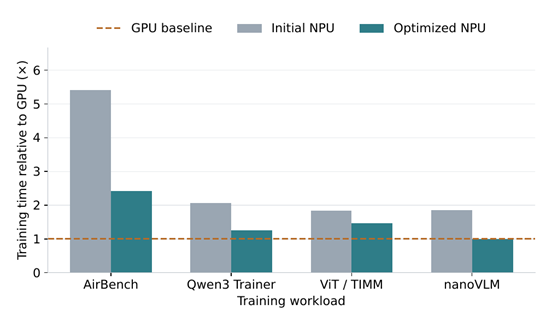
图6 四项训练任务调优前后的训练时间
在科学大模型的实际应用中同样见效:团队将TrainBridge用于单细胞模型BioMod,在包含160万个细胞的预训练数据集上,单轮训练提速约1.84倍;在Immune、Myeloid、HPancreas、MS和Liver五个细胞注释数据集上,单轮训练提速约2.9~3.3倍。
04 共建开放评测基准,协同繁荣国产算力训练生态
为了让更多开发者能够使用和改进这些优化成果,团队基于8卡昇腾910C搭建了经过调优的Modded-NanoGPT训练基准,并上线NPUTrainArena排行榜网站。该基准覆盖Modded-NanoGPT、AirBench、ViT、Qwen3、nanoVLM等多项任务,面向社区开放,支持研究者在统一规范下持续冲击性能纪录、协同迭代优化。
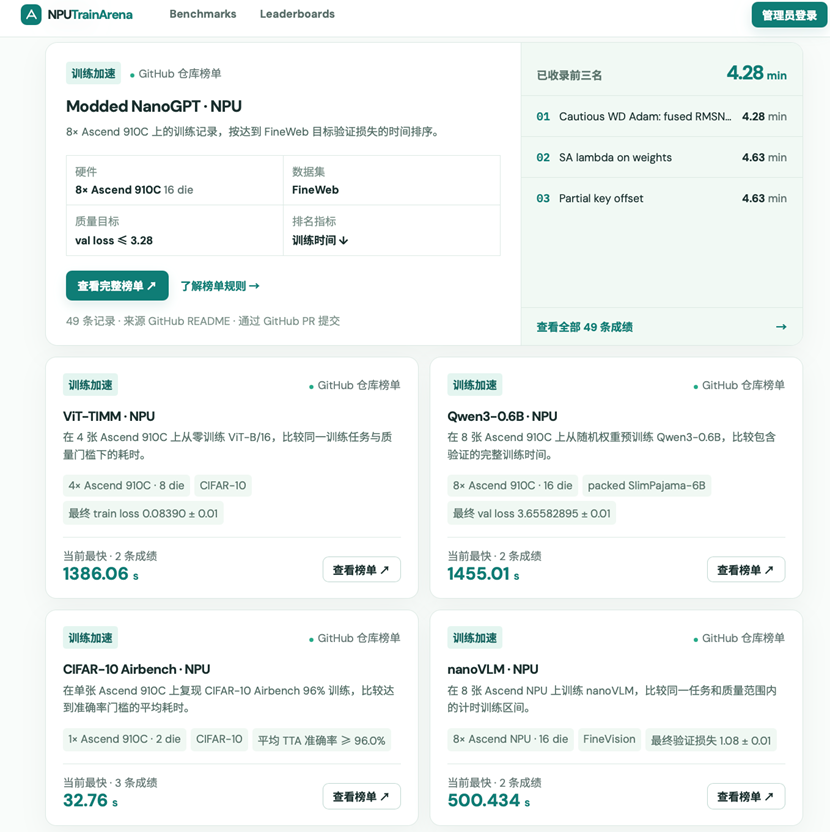
图7 NPUTrainArena排行榜网站
05 聚力国产算力适配攻坚,培育AI领域顶尖人才
国产算力从“可用”走向“好用”,关键一步是让模型不仅跑得起来,更能高效训练。TrainBridge的探索,是把GPU生态中积累的编译优化经验,转化为AI Agent能够借鉴、在NPU上验证的优化线索。一次训练任务的提速之外,这项工作的价值还在于:为跨平台训练优化积累可复用的方法,让后续的模型适配有经验可循。
真实的工程难题,也是培养AI人才的课堂。从模型迁移、性能剖析,到Agent调优与基准验证, TrainBridge将算法、系统与硬件的协同问题带入科研实践。学生不仅要让代码正确运行,还要理解性能瓶颈、提出优化方案,并用实验检验效果,在解决实际问题的过程中锻炼系统思维与工程能力。
让一次优化的成果,成为更多人的起点。通过开放评测基准与社区协作,团队希望让每一次优化都成为可积累、可共享的进步,让青年人才在破解真实难题中成长,让国产算力在持续创新中释放潜能,为中国AI的发展筑牢技术与人才的双重根基。
相关链接
代码仓库:
https://gitcode.com/SLAI/TrainBridge
NPU版Modded-NanoGPT:
https://gitcode.com/SLAI/modded-nanogpt-npu
NPUTrainArena排行榜:
论文全文: