【SLAI Seminar】第四十四期回顾|从可解释性到表达能力:多模态数据生成建模研究
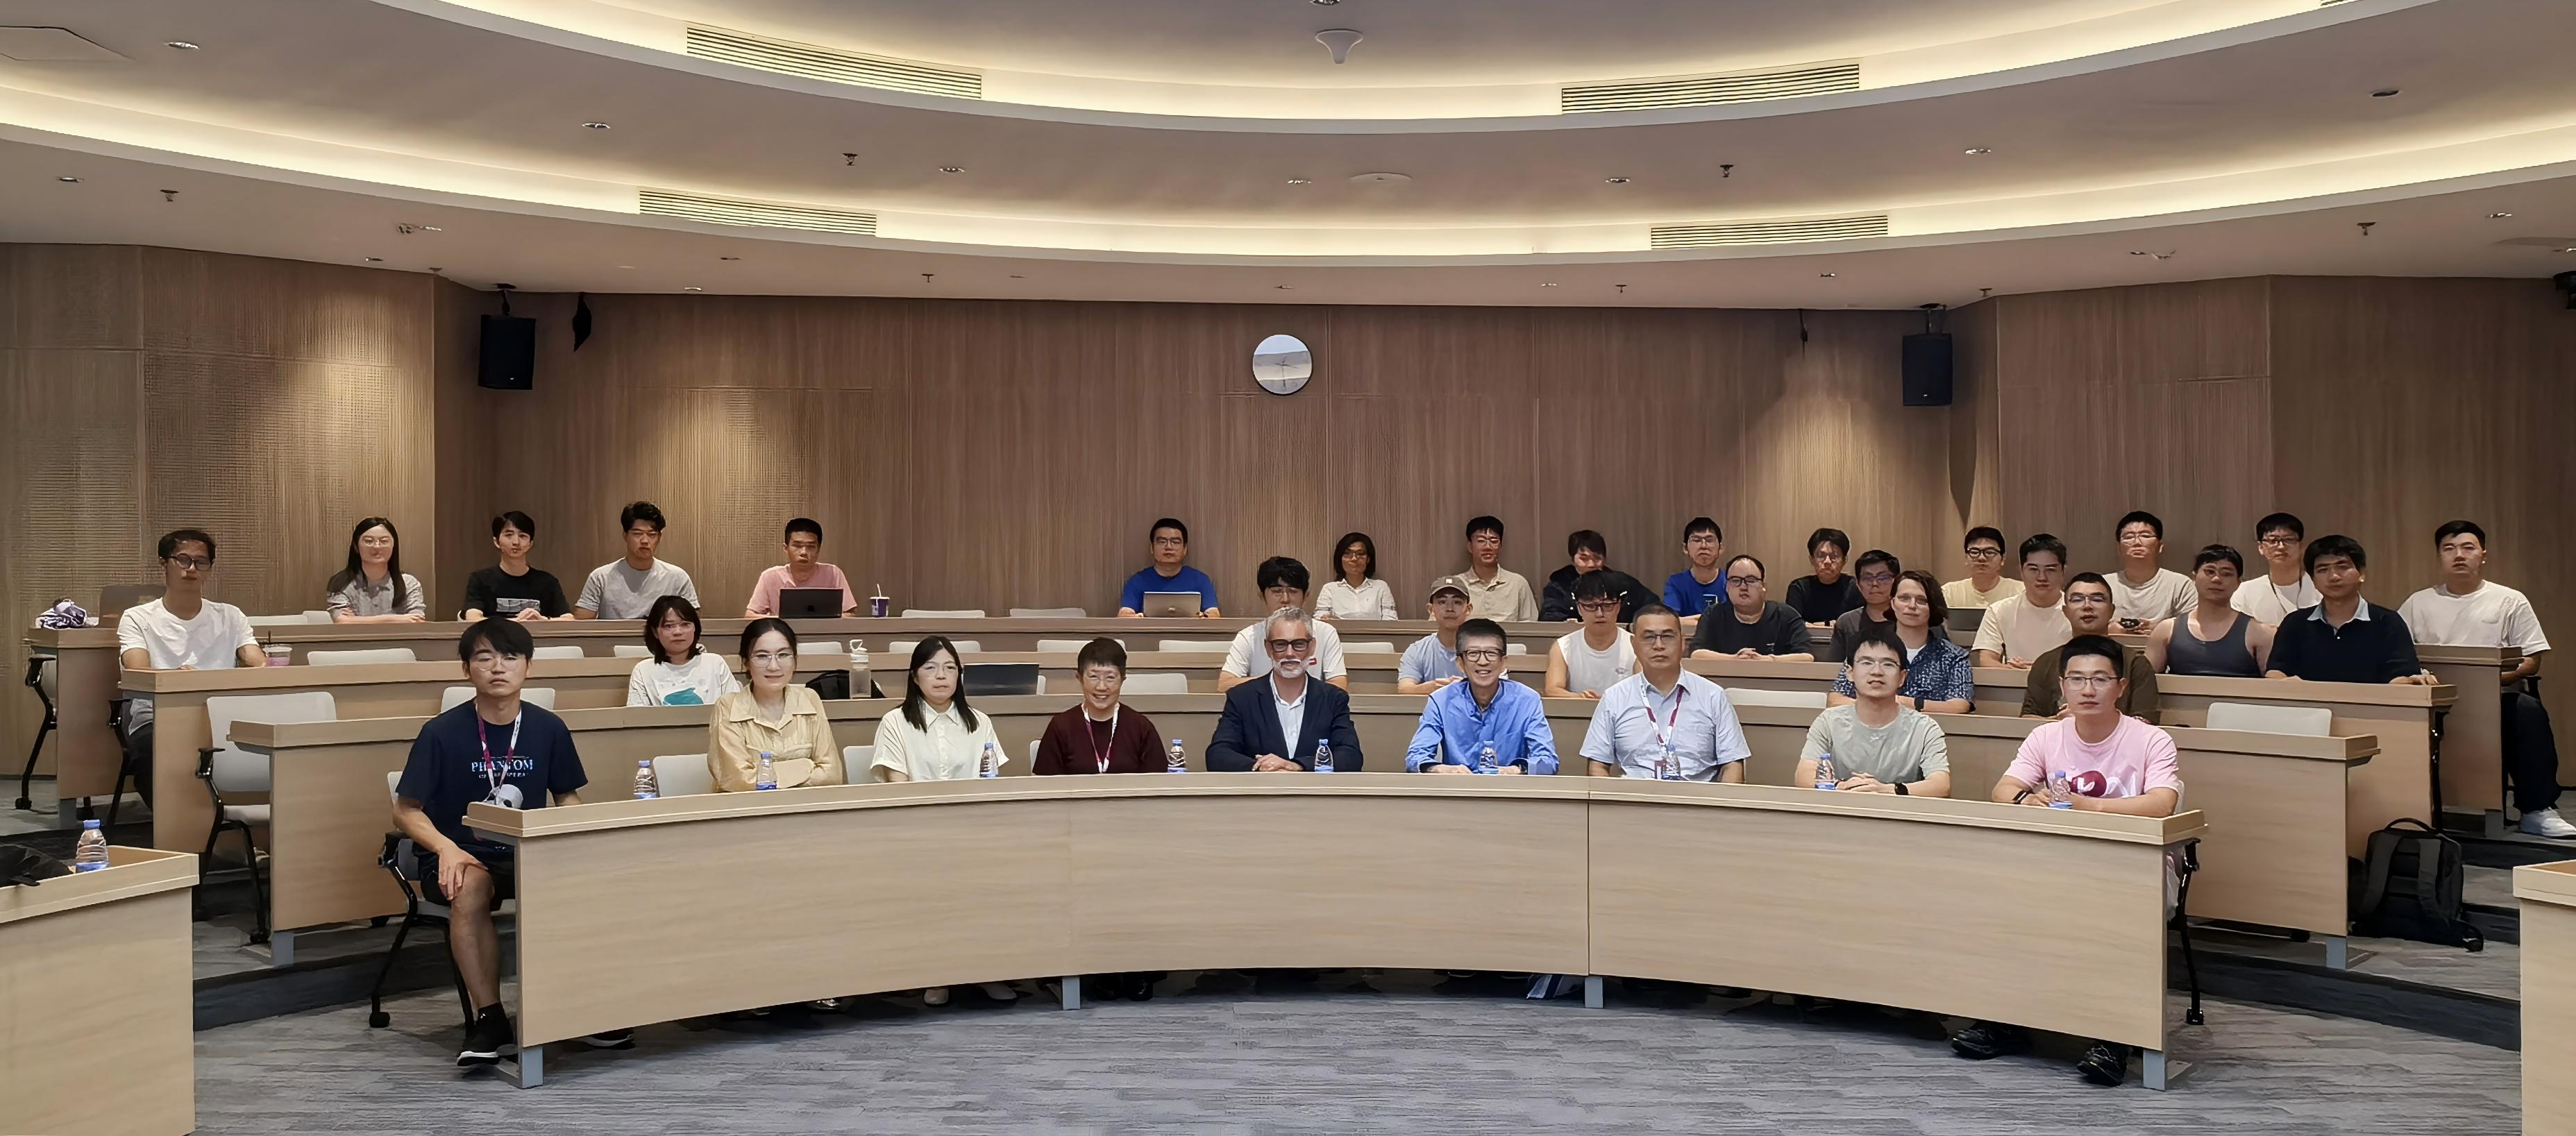
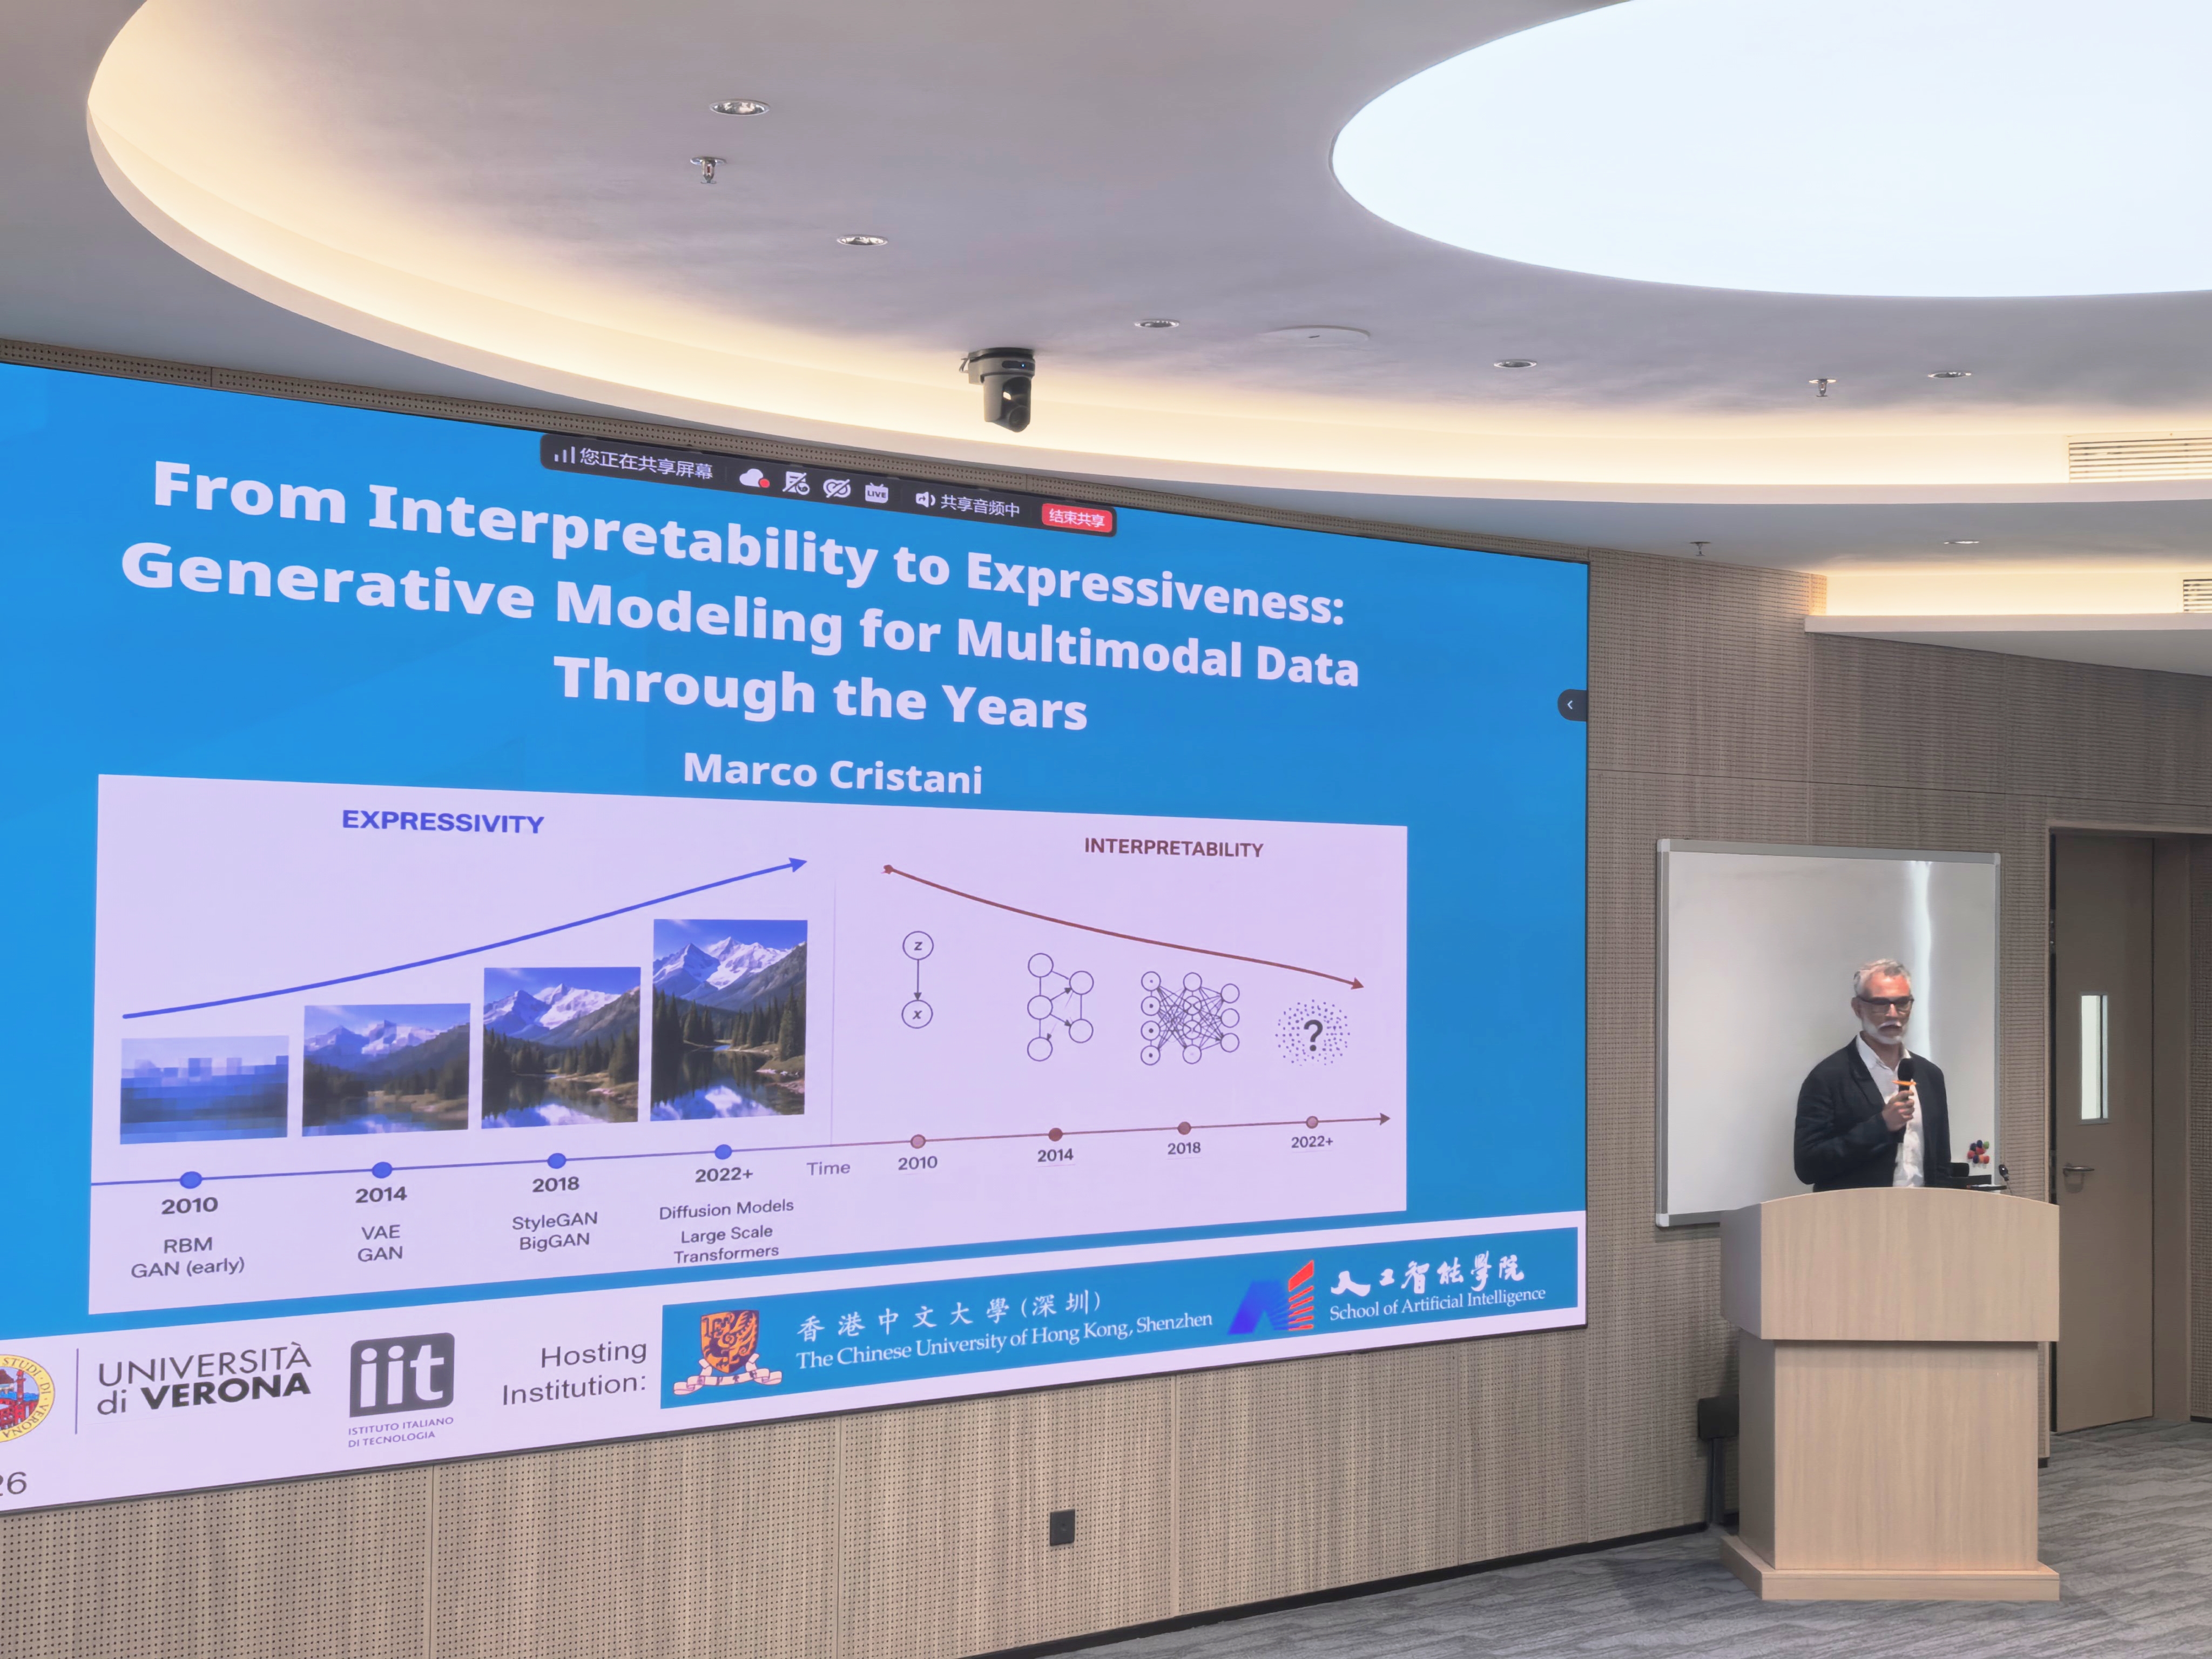
2026年7月23日下午,SLAI Seminar第四十四期在深圳河套学院顺利举办。本次讲座由Tomoko Matsui教授主持,特邀意大利维罗纳大学创新医学工程系Marco Cristani教授主讲。报告以“从可解释性到表达能力:多模态数据生成建模研究”为题,回顾了生成模型近三十年的发展,并介绍了团队在多模态条件生成、多隐变量模型和信息理论分析方面的研究。
讲座内容
01 从可解释模型到高表达生成模型
Marco Cristani教授回顾了早期概率生成模型。这类模型的变量和参数含义较清楚,研究者可以直接观察不同变量如何影响生成结果,但受线性建模能力限制,难以表示真实图像中的复杂变化。
随着VAE、GAN和扩散模型的发展,生成模型开始利用深度网络学习非线性映射,生成质量和多样性明显提高。VAE通过潜变量完成编码与重建,GAN推动了高质量图像生成,扩散模型则通过多步去噪逐渐形成最终样本。与此同时,模型内部的生成过程也越来越复杂,如何理解不同阶段的信息作用、进一步提高可控性,成为新的问题。
02 多模态条件生成:让文字对应到具体区域
在多模态生成部分,Marco Cristani教授以服装设计为例介绍了团队的研究。仅使用全局文本提示时,模型容易出现属性错位,例如把某种纹理生成到错误的服装部位,或者遗漏指定属性。
为此,团队将全局条件细化为“局部草图+局部文本”,让不同服装区域分别对应文字描述,再将这些局部条件持续注入扩散生成过程。这样,模型不仅知道“生成什么”,也能更清楚地知道“生成在哪里”。团队还基于Fashionpedia构建了相应数据,加入草图和经过人工验证的自然语言描述。实验显示,这种方法能够改善局部属性对齐和细节生成。目前,团队也在将这一方法用于交互式服装设计工具。
03 多隐变量模型:理解并控制生成过程
Marco Cristani教授讲述生成模型的理论分析,他介绍了多隐变量生成模型(MLVGM)框架,将VAE、扩散模型等具有多个中间生成步骤的方法放在统一视角下研究。
团队通过扰动不同中间变量,并利用互信息衡量最终图像的变化,分析各变量在生成过程中的作用。实验表明,不同阶段的潜变量对最终结果影响不同:有些更容易改变整体结构,有些主要影响颜色、背景或局部细节。这样的分析也可以用于自监督学习,帮助选择合适的潜变量生成正样本,在保留主要语义的同时产生有效变化。
进一步地,团队从率失真理论出发研究如何组织这些潜变量。标准分层VAE通常只优化最终重建,而扩散模型虽然具有较好的逐步重建能力,却需要大量中间步骤。团队尝试在分层VAE的多个中间阶段同时加入重建约束,使不同潜变量按照设定的信息容量逐步改善生成结果,从而兼顾较少的潜变量、较好的表达能力和更清晰的控制方式。目前这一方向仍处于早期阶段,模型轻量化也是后续需要解决的问题。
在交流环节,现场师生围绕模型的可扩展性与潜变量可控性展开了进一步讨论。针对“多隐变量生成框架能否拓展到视频等包含时间动态的数据”,Marco Cristani教授表示,从理论上看,该框架并不局限于静态图像,也可以用于更一般的信号建模;但目前研究仍处于较早阶段,团队首先从图像任务入手,视频中的时序依赖和动态变化还需要进一步验证和设计。对于“不同中间潜变量究竟控制哪些具体视觉属性”问题,Marco Cristani教授指出,现阶段团队更关注每个潜变量对最终生成结果携带多少信息、产生多大影响,而不是预先规定某个变量对应颜色、姿态或纹理等固定语义,因为这类对应关系往往高度依赖具体模型和网络结构。
 |  |
本次讲座从生成模型的发展历程出发,讨论了可解释性与表达能力之间的关系。Marco Cristani教授结合多模态服装生成和多隐变量模型研究,介绍了如何利用局部条件、互信息和率失真理论理解并控制生成过程,为多模态生成模型的进一步研究提供了新的思路。