【SLAI Seminar】第四十二期回顾|大语言模型预训练优化:全新算法、理论与研究洞见
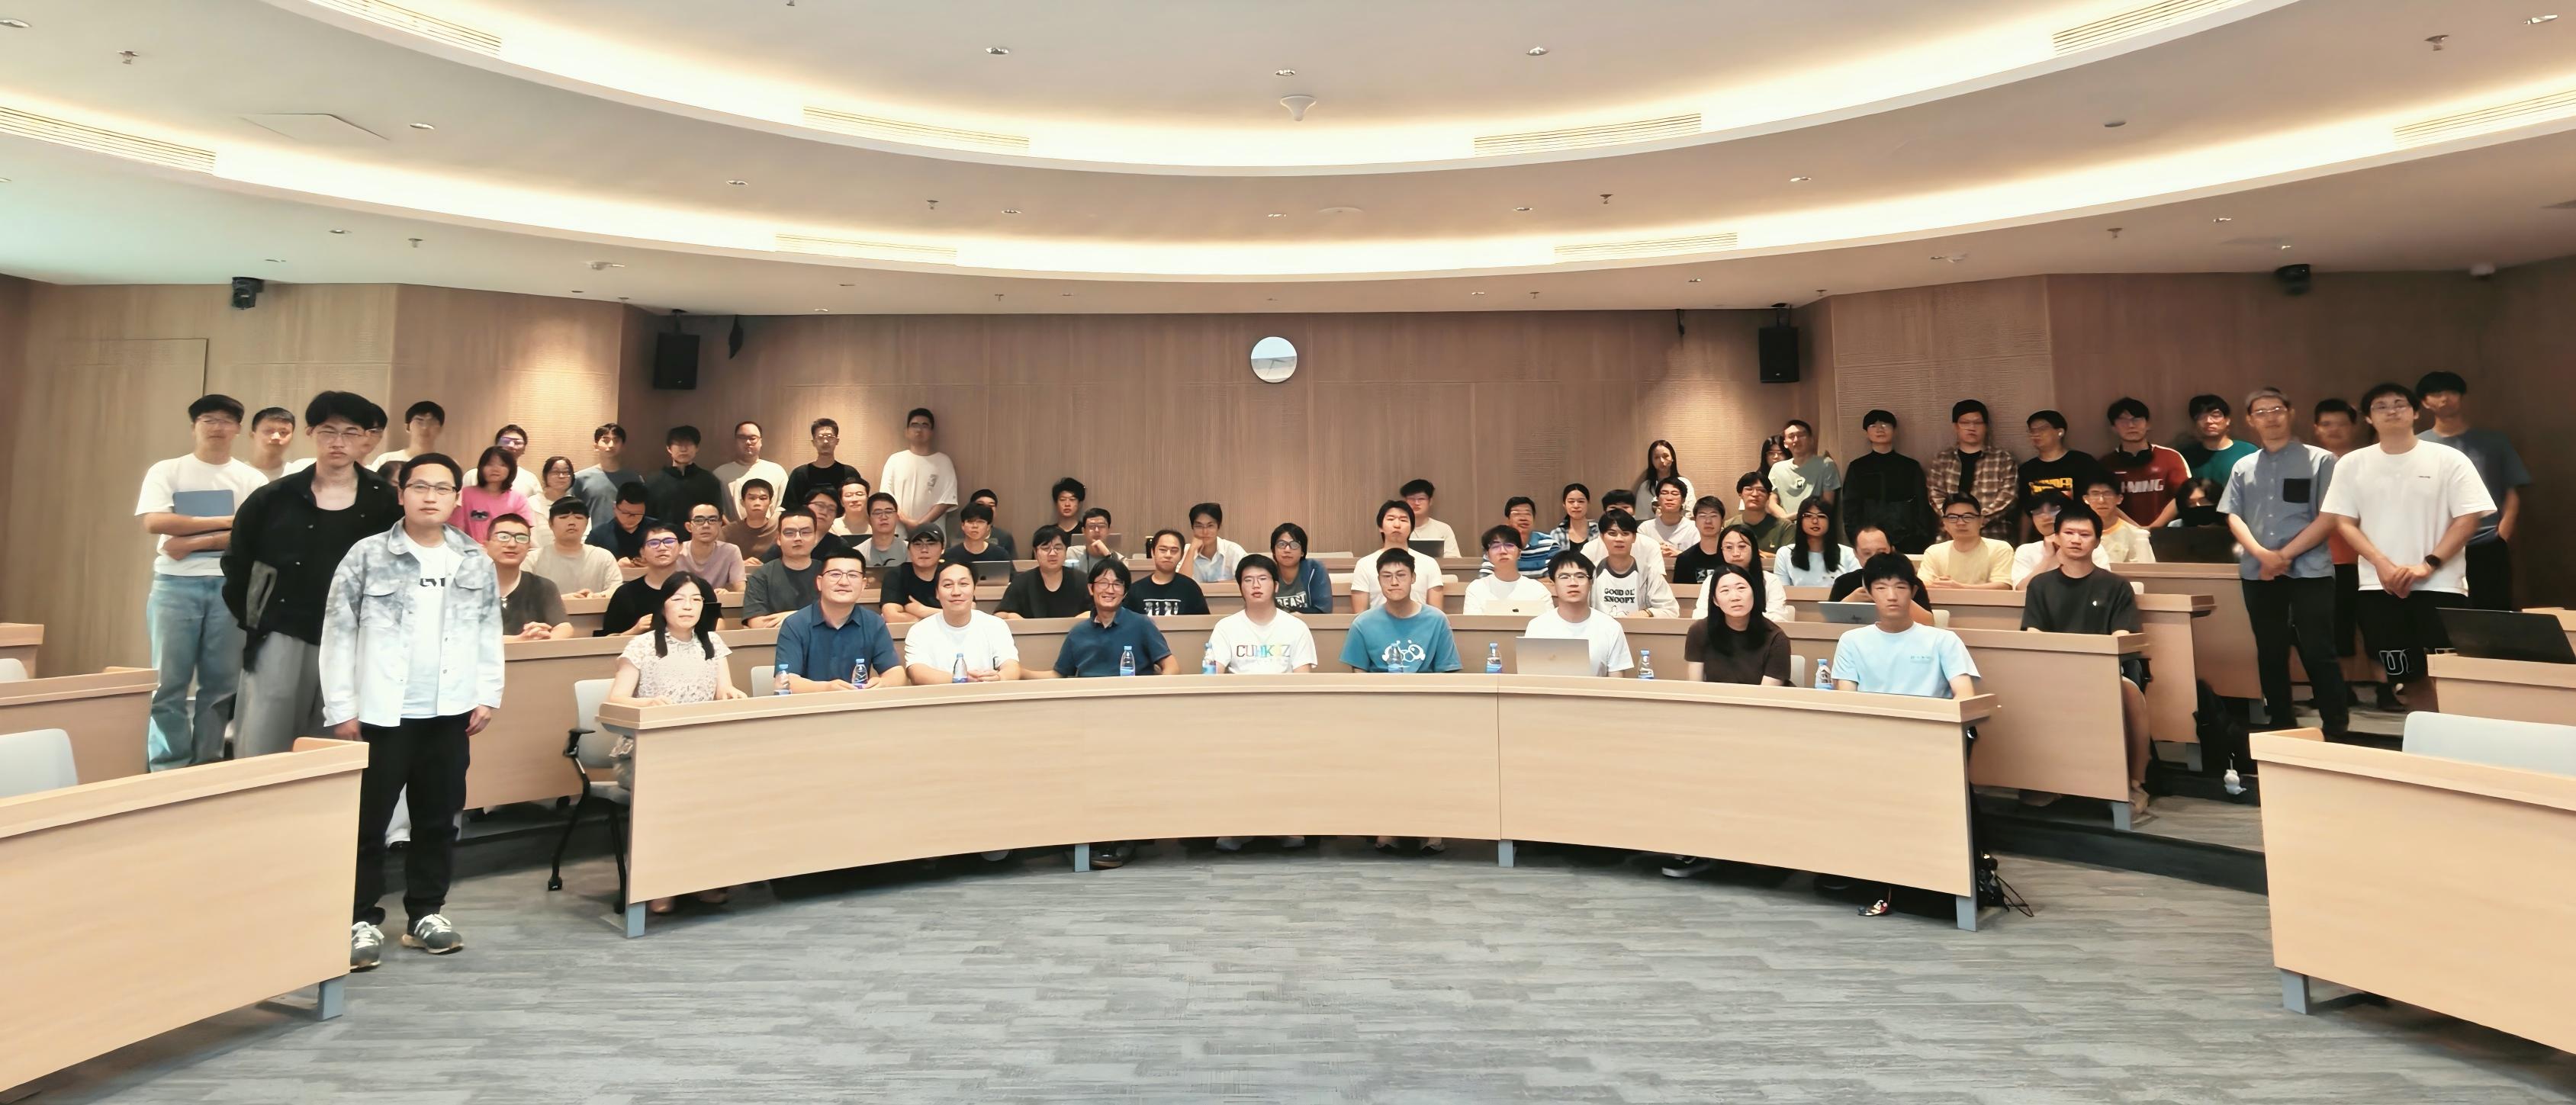
2026年7月1日下午,SLAI Seminar第四十二期在深圳河套学院顺利举办。本次讲座由王祥丰教授主持,特邀明尼苏达大学双城分校电气与计算机工程系洪明毅教授,围绕“大语言模型预训练优化:全新算法、理论与研究洞见”主题,系统分享了其团队在优化器底层机理分析、极简内存算法设计及经典动量稳定化等方面的最新研究成果。
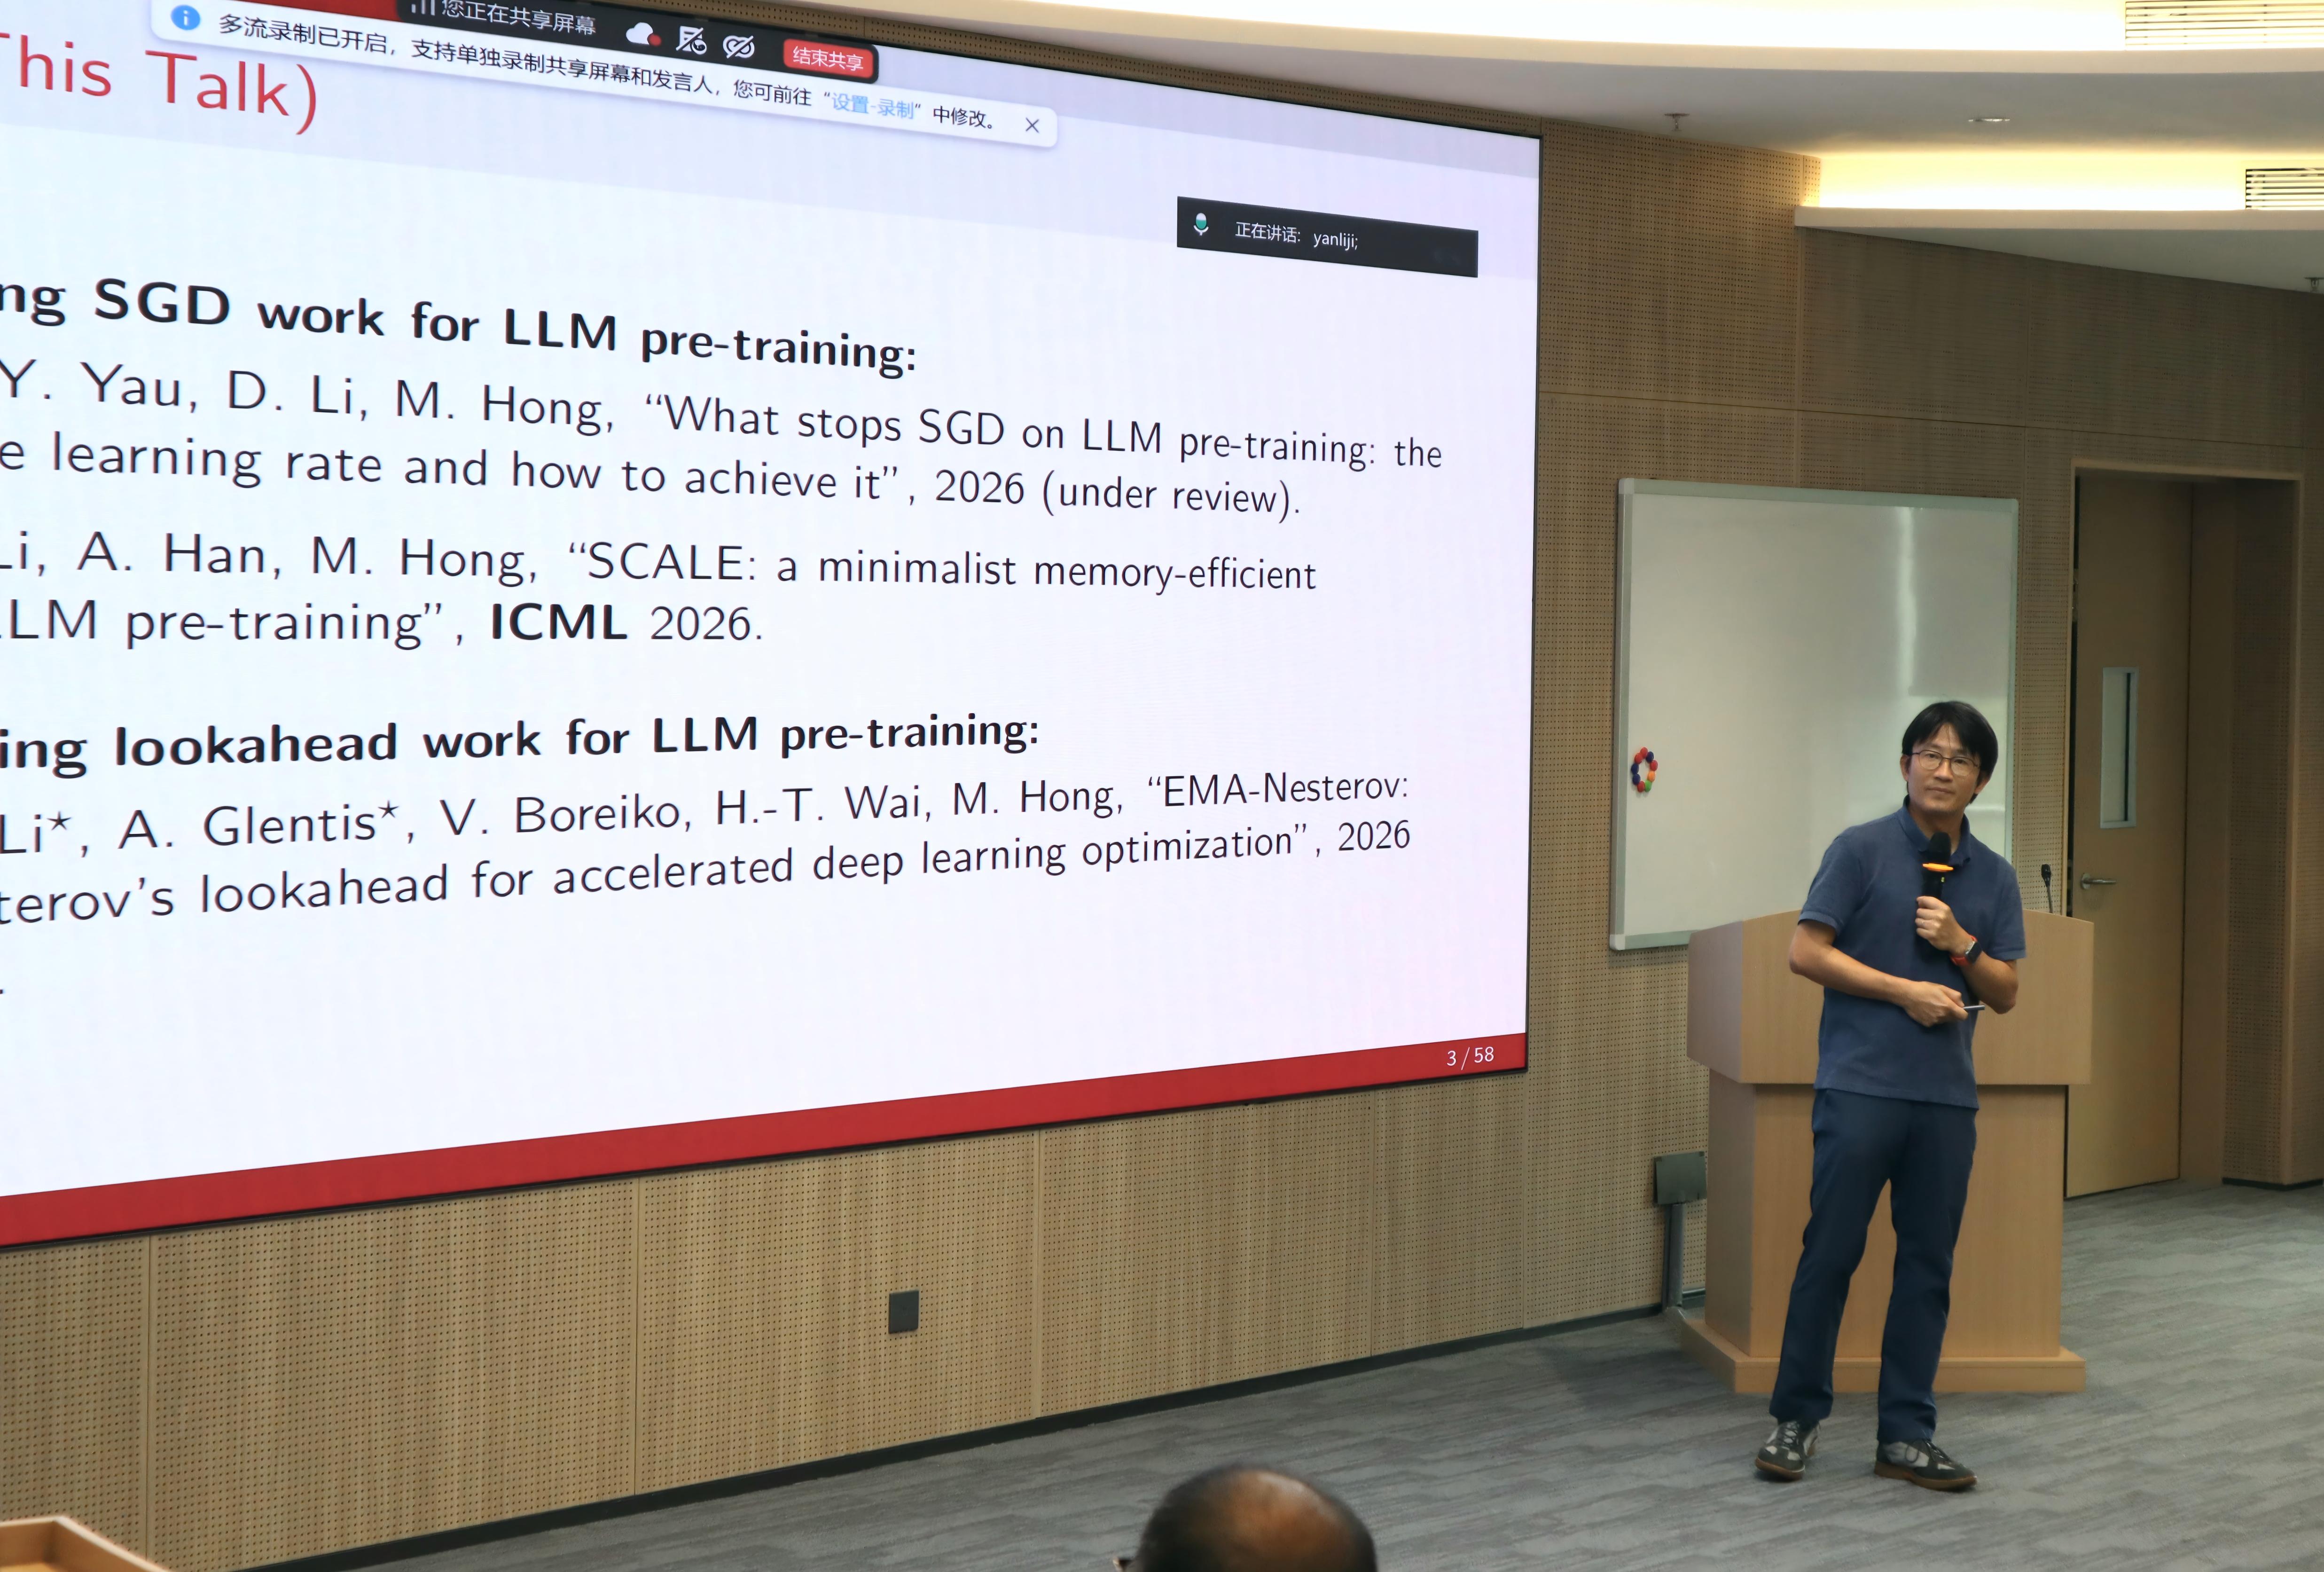
讲座内容
01 破解SGD的优化困境:梯度结构分析与有效学习率
大语言模型预训练高度依赖Adam等自适应优化器,而传统的随机梯度下降(SGD)往往表现不佳。洪教授团队通过实证与理论分析指出,SGD失效的根本原因并非损失函数景观的固有缺陷,而是大语言模型随机梯度的结构性特征:模型权重与梯度范数的比值极度失衡,且随批次规模增大而加剧。
同时,梯度在不同网络层表现出剧烈的波动,特别是语言模型头在不同词元类别上的梯度范数存在多个数量级差异,高频词元占据了主导地位。这些不规则性严重限制了SGD的可用学习率。研究表明,通过实施层级与词元级的简单梯度裁剪机制,有效提升了SGD的有效学习率,使其在训练性能上大幅缩小了与Adam的差距。
02 SCALE优化器:构建极简且内存高效的训练算法
基于对SGD改进机制的提炼,洪教授团队开发了名为SCALE(Stochastic Column-normAlized Last-layer momEntum)的内存高效优化器。该算法摒弃了传统优化器中全局动量与二阶矩带来的庞大内存开销,通过“加法”思维仅保留了两个核心组件:按列进行梯度归一化,旨在平衡不同词元的特征更新,以及仅在输出层施加指数移动平均(EMA)动量。
实验结果证明,SCALE算法的内存占用仅为Adam的35%至45%。在高达7B参数规模的大语言模型预训练中,其收敛性能与计算效率与主流的内存高效优化器持平甚至更优,验证了通过保留最少必要状态实现高效训练的理论可行性。
03 EMA-Nesterov:经典加速算法的稳定化适配
涅斯捷罗夫(Nesterov)前瞻动量在凸优化中具有显著的加速收敛效果,但在深度学习中常因非凸的“河谷型”损失地形而表现出极强的不稳定性。洪教授指出,传统的Nesterov算法仅依赖上一步的更新向量作为前瞻方向,极易在陡峭的地形中偏离轨道导致损失发散。
为此,团队提出了EMA-Nesterov变体,通过对历史更新方向进行指数移动平均,获得更为平滑稳定的前瞻轨迹。该方法具有极高的泛化性,可作为通用插件无缝封装于Adam、Muon、SOAP等现有主流优化器之上。在NanoGPT等基准测试中,该插件持续提升了基础优化器的训练速度,并刷新了多项预训练收敛的步数记录。
在讲座尾声的交流环节,针对“前瞻动量如何应对快速变化的损失地形”这一问题,洪教授解释道,利用EMA跟踪历史方向能够有效过滤局部噪声;在实际工程部署中,将前瞻步长的控制参数与整体学习率调度曲线保持同步衰减,即可确保算法在不稳定的初始阶段维持收敛,并在后期充分发挥加速优势。
 |  |
本次讲座系统梳理了经典优化算法在大模型训练时代的局限性与重构路径。洪明毅教授结合底层梯度结构诊断,展示了如何通过剥离非必要内存状态与稳定前瞻动量,设计出兼具计算效率与收敛性能的新一代优化器。这为突破大规模神经网络训练的内存瓶颈、优化底层算力利用率提供了严谨的理论指导与实践范式。