【SLAI Seminar】第四十一期回顾|智能体AI时代:从以模型为中心的学习到以数据为中心的学习
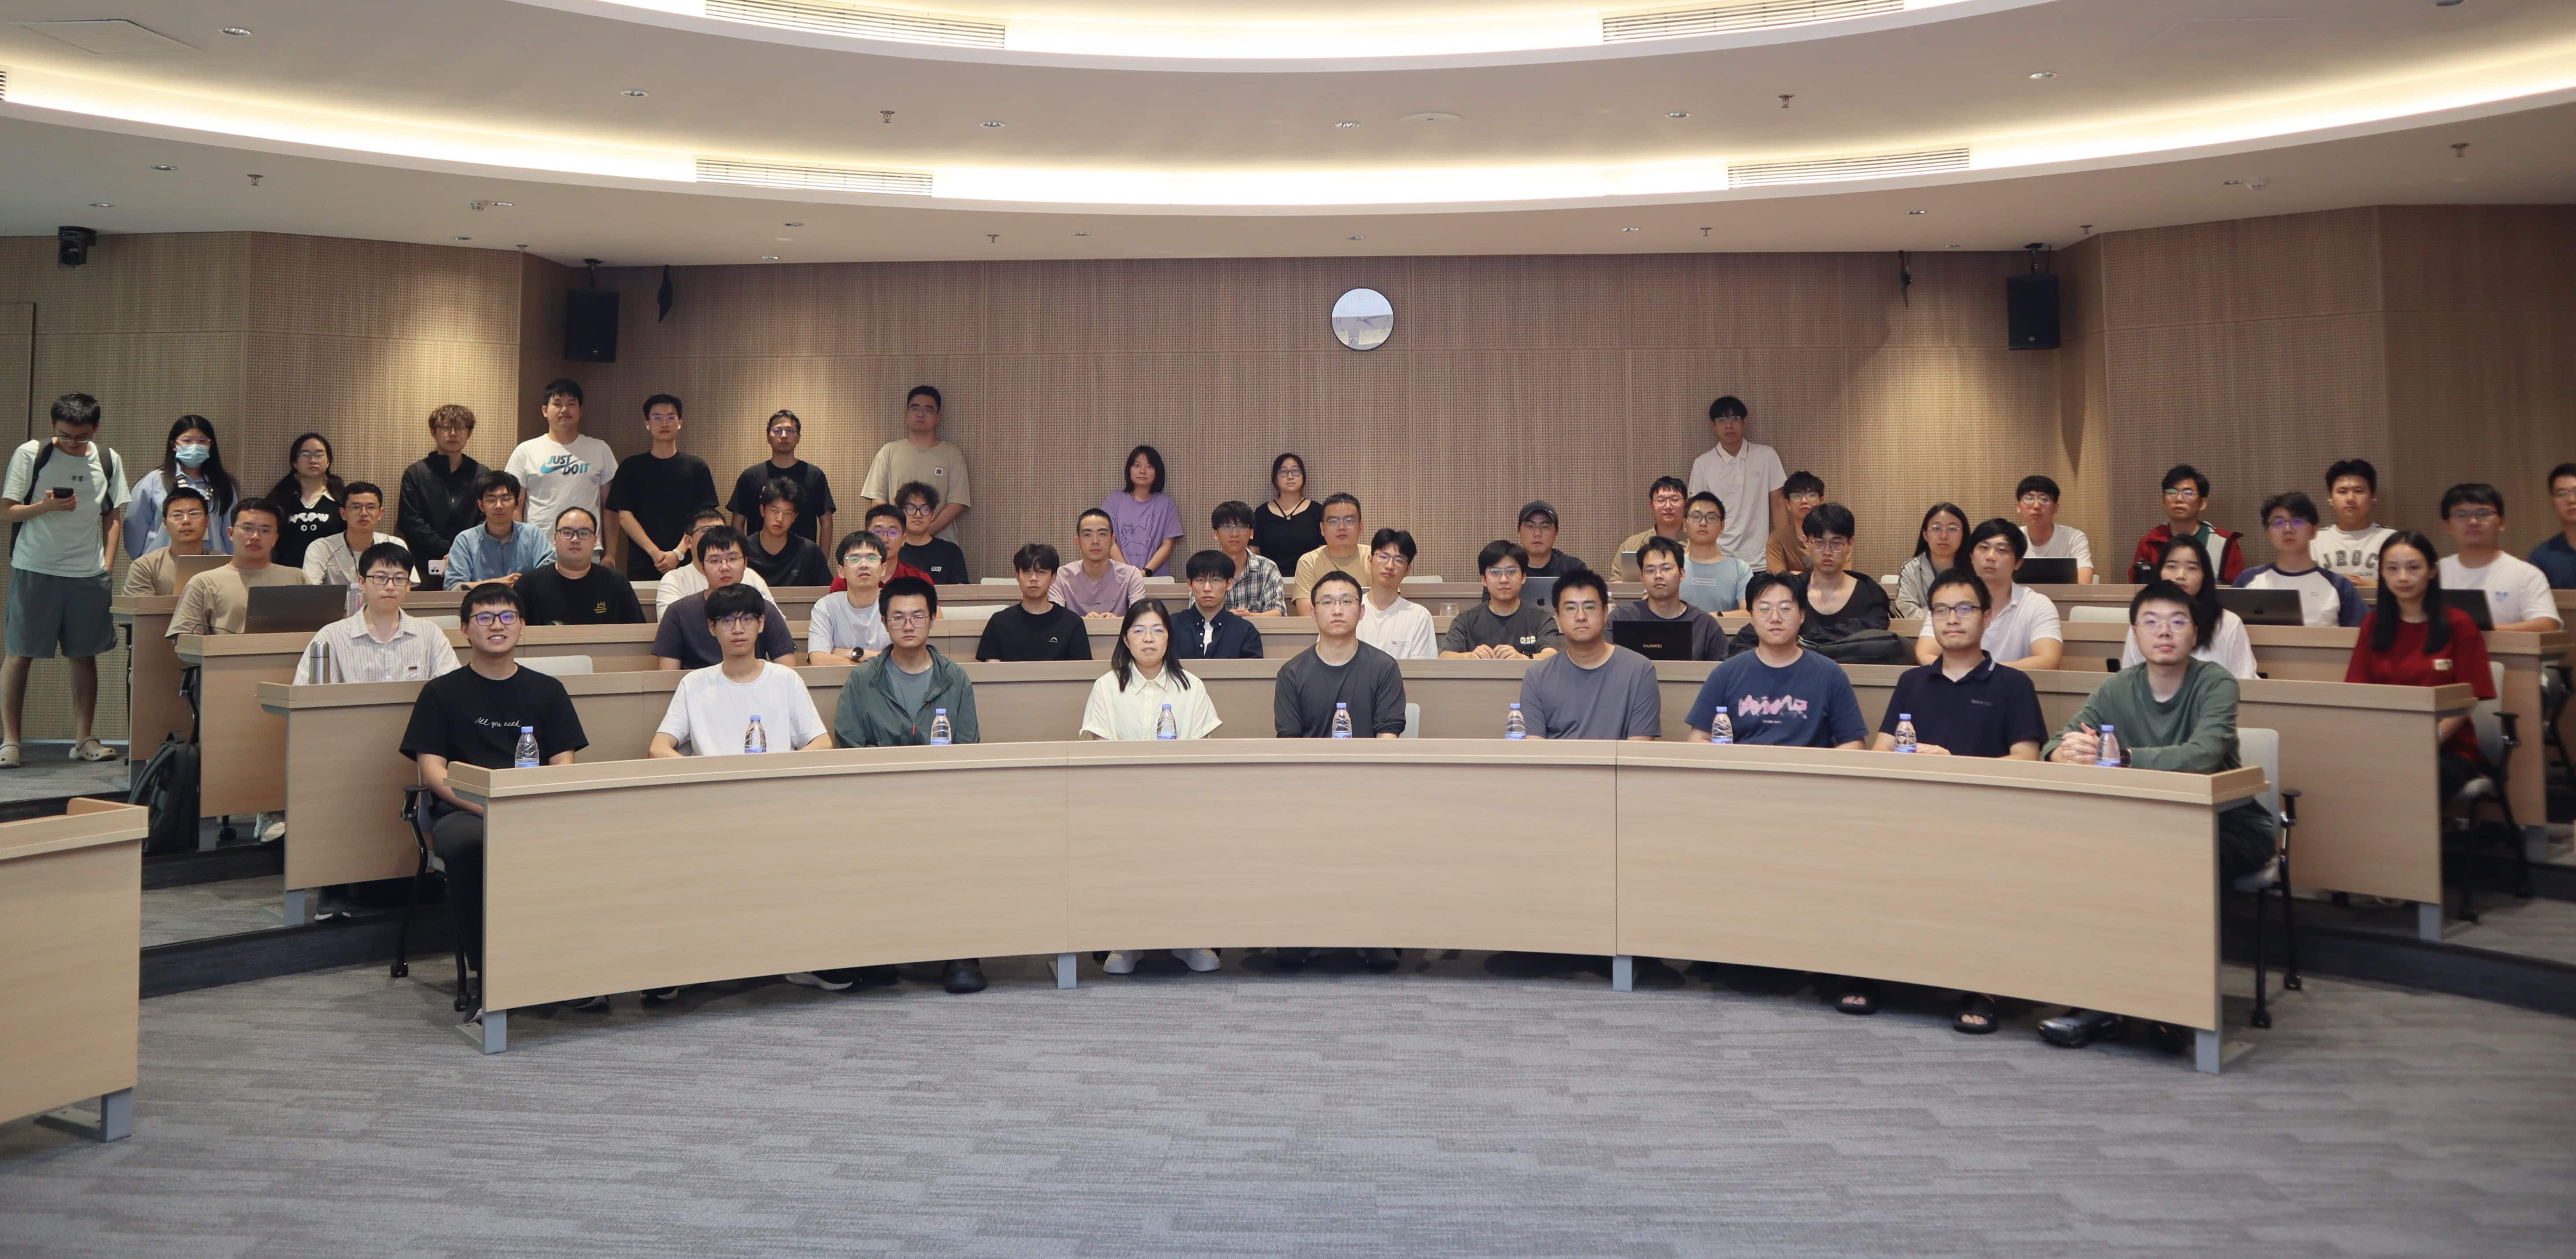
2026年6月25日下午,SLAI Seminar第四十一期在深圳河套学院顺利举办。本次讲座是“智能体系列”的第七讲,由姚天峻助理教授主持,特邀穆罕默德·本·扎耶德人工智能大学(MBZUAI)长聘助理教授、VILA实验室负责人沈志强博士主讲。沈博士以“智能体AI时代:从以模型为中心的学习到以数据为中心的学习”为主题,系统阐述了人工智能研究重心的转移,并深入分享了团队在数据压缩、对抗攻防、数据混合比例解析等方面的最新工程实践与理论分析。
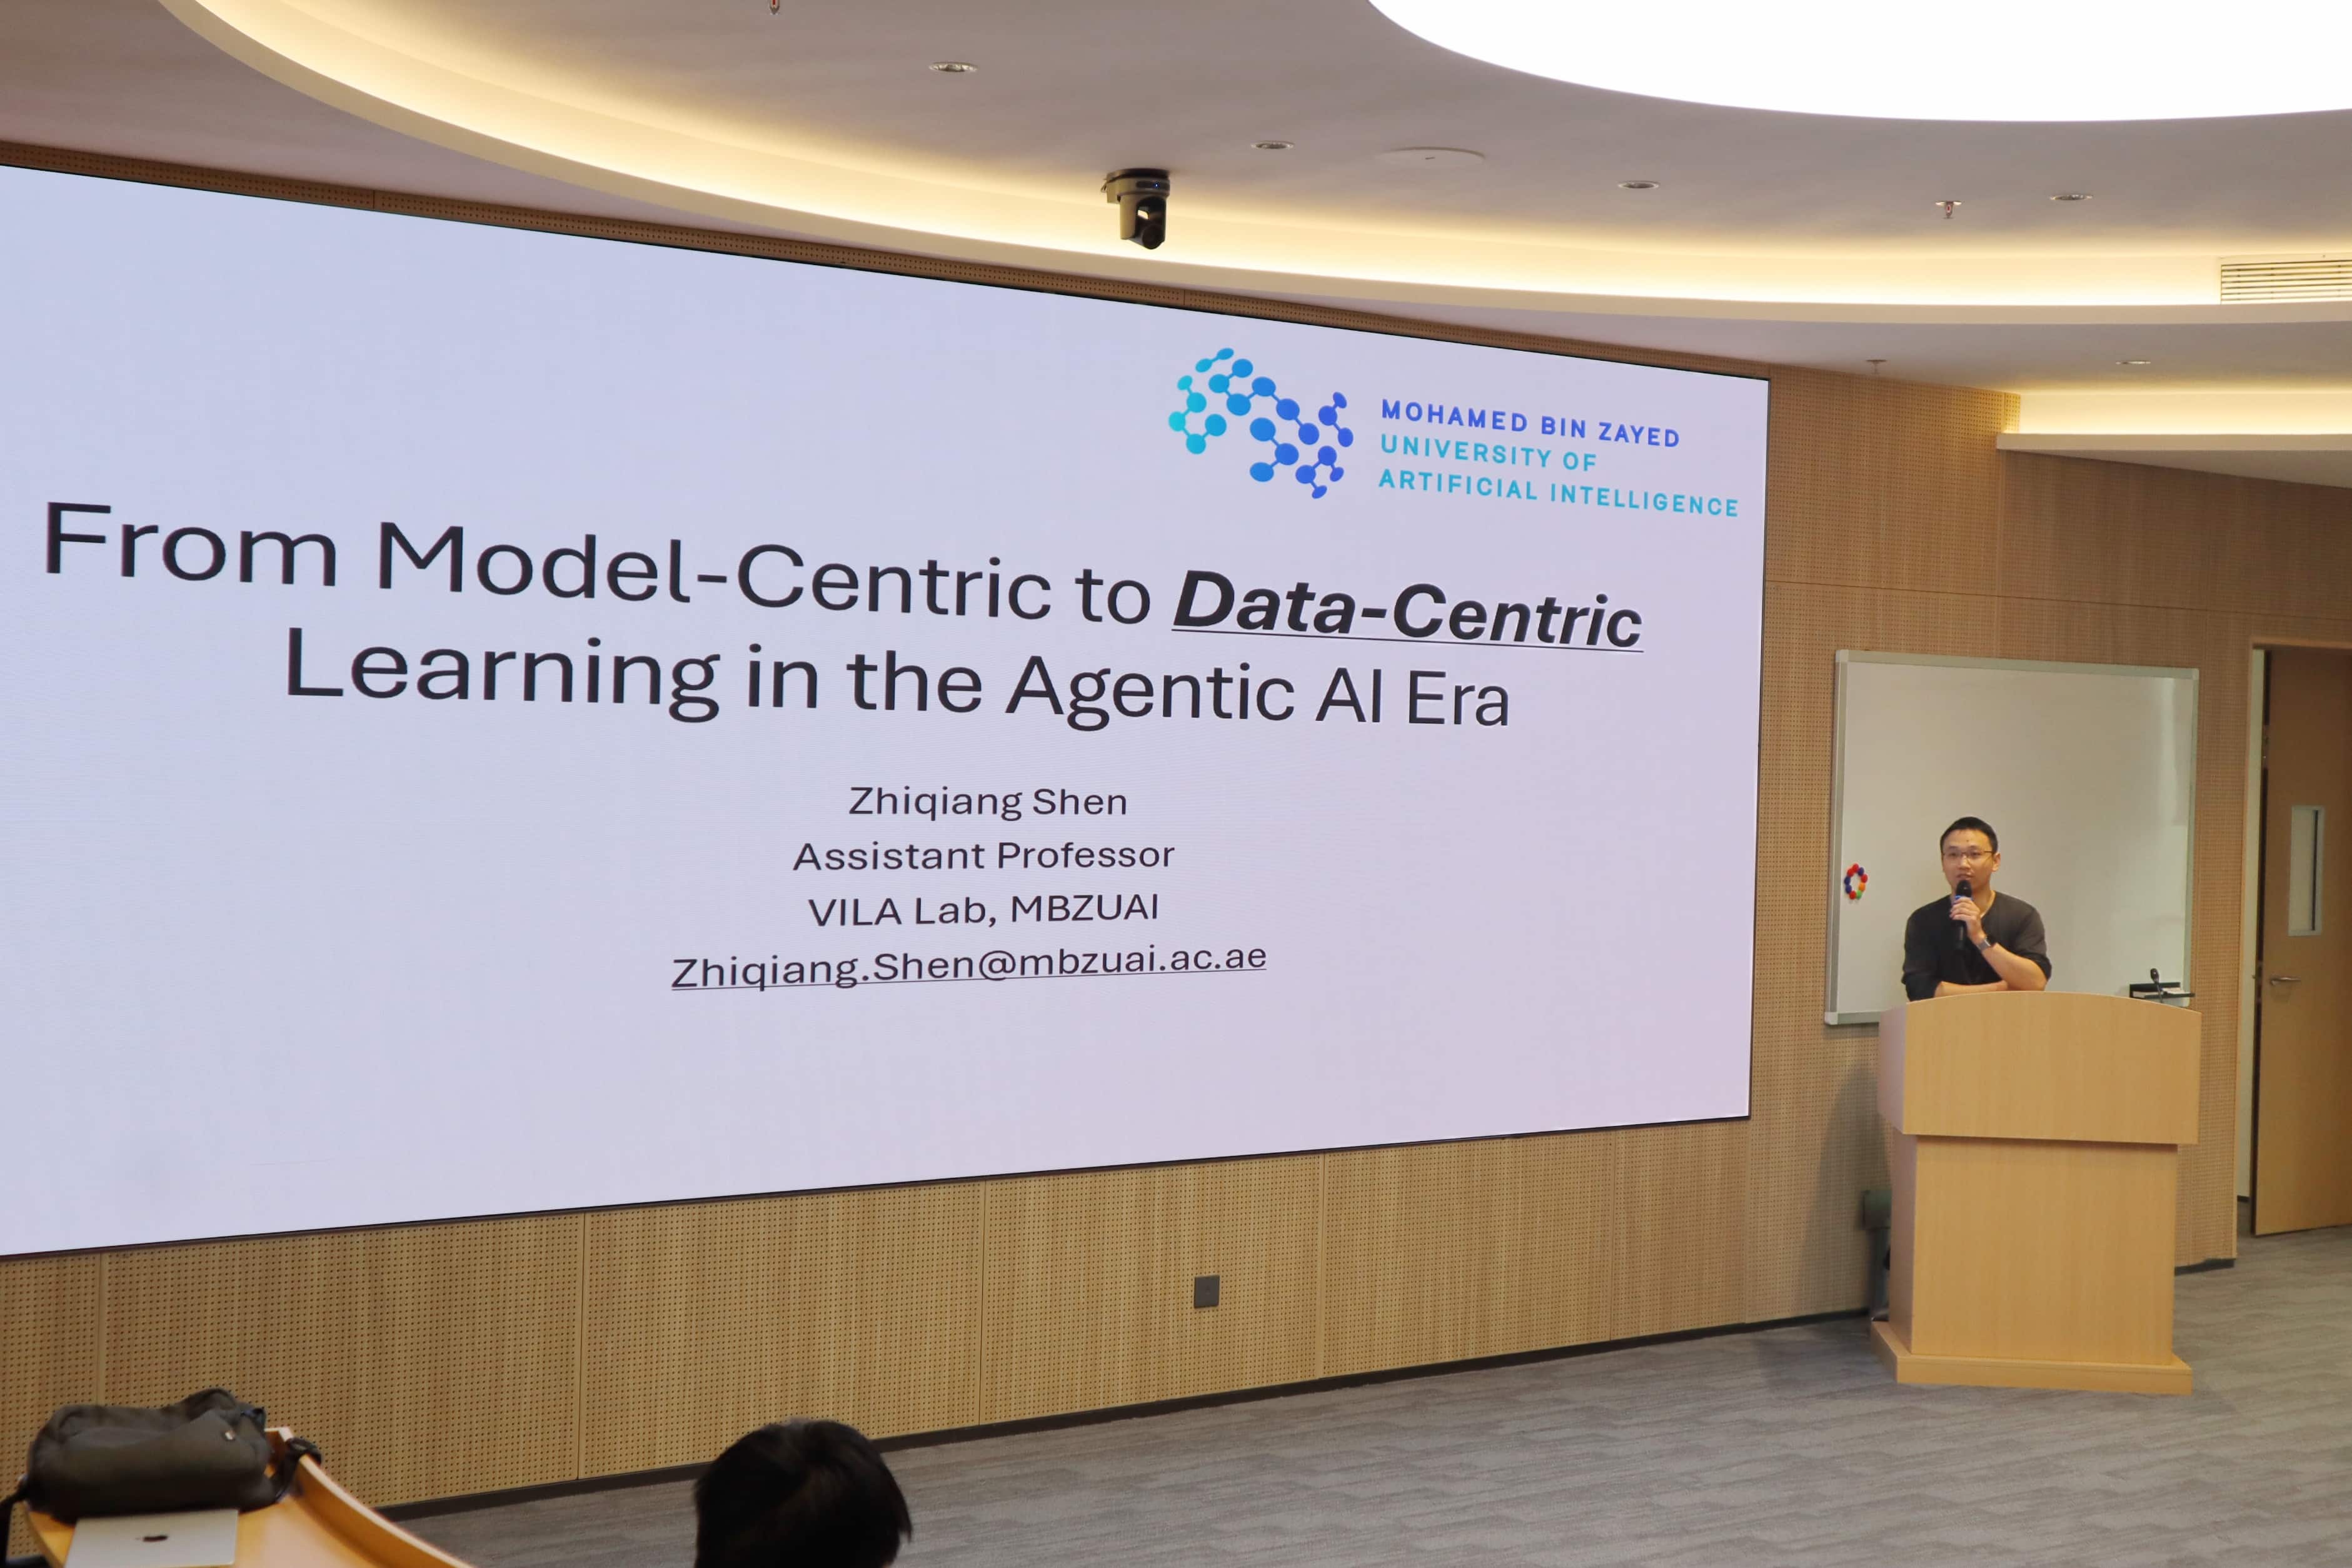
讲座内容
01 范式演进:从“以模型为中心”向“以数据为中心”转型
沈志强教授开篇指出,过去十余年人工智能的演进主要由“以模型为中心”的架构驱动,以AlexNet、ResNet及Transformer的发展为典型代表。然而,随着基础模型架构的日趋收敛,算法层面的改进所带来的边际收益正在递减,进一步的性能突破将高度依赖于底层数据的质量、分布与组织方式。
在智能体AI时代,“以数据为中心”的研究非常重要。智能体在复杂环境中执行任务时,不再仅依赖静态的图文对,而是涵盖了交互历史、工具输出、图形用户界面(GUI)状态及用户反馈等动态多模态数据。这要求研究者将数据获取、提纯、生成与安全防御作为一个完整的系统工程进行审视。
02 数据压缩与提纯:突破数据集蒸馏的计算瓶颈
数据集蒸馏旨在将庞大的原始数据集压缩为极小规模的合成数据,同时保留训练高性能模型所需的核心信息。针对传统双层优化方法在内存与计算开销上面临的扩展性瓶颈,沈教授团队提出了解耦数据生成与参数优化的重构方案。
通过利用预训练模型自身提取的信息,并结合批归一化层的统计量匹配,该方案有效实现了目标合成数据的逆向恢复。在此基础上,研究团队引入了课程数据增强(Curriculum Data Augmentation)策略,使数据生成从全局轮廓优化平滑过渡到局部细节重构。此外,团队还将残差结构引入数据层,提出了数据残差连接(Data Residual Connection),通过周期性融合原始数据特征来减轻信息衰减。在针对3D长尾数据集的数据剪枝(Pruning)研究中,团队提出了两阶段的样本筛选机制,有效平衡了整体准确率与类别平均准确率之间的权衡关系。
03 数据安全与评测:多模态对抗攻防与新一代验证码设计
面对当前视觉语言模型(VLM)在复杂交互中的安全性问题,沈教授展示了针对大模型的对抗攻击方案M-Attack。该研究通过在潜空间进行局部到局部的特征匹配,对原始图像施加极微小的像素级扰动,即可使主流闭源视觉语言模型在识别时完全偏离输入内容。后续版本进一步引入了多裁剪对齐机制以稳定梯度方差,大幅提高了对抗样本生成的效率与成功率。
另一方面,针对能力不断增强的自动化智能体可能造成的系统负荷问题,团队设计了新一代验证码数据集。测试表明,前沿智能体在复杂视觉结构解析、动态信息整合及长程记忆规划上依然存在显著短板,导致其通过率远低于人类水平。这为评估和控制智能体行为边界提供了客观的基准工具。
04 模型解析与溯源:数据配比推断与生成内容追踪
对于大量未公开训练细节的闭源模型,理解其底层数据配比具有重要的工程参考价值。沈教授团队提出了数据混合配比恢复方法:首先在已知数据源上训练基础分类器计算混淆矩阵,随后基于目标模型生成的大量文本得出预测分布,最终通过优化校准机制反推得出真实、无偏的训练数据领域分布比例。
在应对AI生成内容的滥用风险方面,团队建立了针对图像和文本模态的生成追踪框架。图像检测致力于实现像素级的精准篡改定位;文本检测则通过模拟人类与AI交互修改的动态演进轨迹,构建了符合真实应用场景的阶梯式检测基准,以提升检测算法在多轮修改下的鲁棒性。
在交流环节,现场师生围绕多模态数据压缩、大模型数据规模策略等议题展开了探讨。针对“以数据为中心”的方法如何拓展至具身多模态智能的提问,沈教授指出,不同模态间的相互依赖使得联合压缩极为复杂,例如在压缩图像时必须同步调整文本标注的语义边界,这需要构建跨模态的特征对齐与信息熵度量体系。在探讨数据混合比例对最终性能的影响时,他认为当前大模型发展尚未达到数据吞吐的饱和点,通过缩放定律(Scaling Law)直接扩增数据规模所带来的收益更为直接;但当数据达到天花板后,特定领域数据的配比优化将成为决定模型专业性能的关键。
本次讲座系统梳理了人工智能重心从模型架构向底层数据工程迁移的发展脉络。沈志强教授结合丰富的工程实践,客观分析了在智能体AI架构下,如何通过数据集蒸馏、多模态对抗攻防与数据溯源技术,提升模型的计算效率、鲁棒性与安全性。这为理解大规模智能系统的数据运行机制及优化AI数据治理提供了严谨的科学路径。